Metody strukturované analýzy a projektování MIS – I
Rozdíl mezi metodikami a metodami, vztah mezi nimi. Nástroje strukturovaných metod: Strukturovaný text, vývojové diagramy, ERD, DFD.
Metodika – je doporučený souhrn etap, přístupů, zásad, pravidel, dokumentů, řízení, metod, technik a nástrojů pro tvůrce informačních systémů, který pokrývá celý životní cyklus informačních systémů. Určuje kdo, kdy, co a proč má dělat během vývoje a provozu IS. Metodika by se měla vztahovat na všechny prvky IS (pracovníky, organizační procedury, data, SW a HW), organizační vlivy IS, ekonomické otázky spojené s vývojem a provozem IS a doporučené dokumenty a případně způsob řízení v jednotlivých fázích životního cyklu IS
Metoda – určuje, co je třeba udělat v určité fázi nebo činnosti vývoje či provozu IS. Metoda je vždy spojena s určitým přístupem, jako je funkční, datový nebo objektový přístup. S přihlédnutím k této charakteristice řeší každá metoda postup činností v určité části (jedné nebo několika fázích) procesu vývoje systému, nebo pouze z některého úhlu pohledu na systém (data, funkce, SW, HW, atd.)
příklady: informační analýza, funkční analýza, analýza konceptuálních tříd a procesů, aj.
Vtah metodiky a metody: Nelze jednoznačně prohlásit, že jednotlivé metody patří určitým metodikám. Metodiky se odkazují na příslušné metody v relevantních místech životního cyklu IS, přičemž některé metody jsou více specifické, jiné mají univerzálnější charakter (například na metody datového modelování se odkazují téměř všechny metodiky)
Nástroje strukturované analýzy – Při analýze systému je zapotřebí vytvořit několik modelů, které představují napodobeninu reálného systému. Tyto modely zachycují všechny důležité rysy a zakrývají nepodstatné rysy systému. Veliká výhoda modelů je, že usnadňují komunikaci se zákazníkem. Pokud analytik navrhl modely dostatečně jednoduché a srozumitelné, aby je zákazník pochopil, může s ním diskutovat změny a opravy podle požadavků zákazníka s minimálními náklady a rizikem. Podle pohledu na systém se modely analýzy dělí na 2 základní skupiny:
Strukturovaný přístup
Diagram datových toků (Data Flow Diagram - DFD)
DFD je jeden z nejpoužívanějších modelovacích nástrojů strukturované analýzy, který poskytuje funkčně orientovaný pohled na systém. Slouží tedy k modelování funkcionality systému. DFD zobrazuje systém jako síť procesů. Tyto procesy plní určité funkce a pomocí datových toků si mezi sebou předávají data.
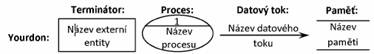
Diagram datových toků obsahuje následující čtyři komponenty:
· Terminátory reprezentují externí entity, které patří do okolí systému a se kterými systém komunikuje. Všechny informace, které systém přijímá nebo vysílá jsou vysílány, respektive přijímány terminátory. Terminátory jsou nejčastěji osoby nebo skupiny osob, ale mohou to být i jiné systémy, se kterými náš systém komunikuje. Analytik ani systém nemůže změnit obsah terminátorů nebo způsob jakým pracují.
· Procesy jsou jediné části systému, které převádějí vstupy na výstupy. Každý proces by měl být jednoznačně identifikován a vhodně pojmenován, buďto jedním slovem, jednoduchou větou nebo frází. Jméno vyjadřuje, co daný proces dělá. Ke každému procesu na DFD existuje buď minispecifikace, nebo je dekomponován na nižší úrovni DFD, kde jsou znázorněny jeho subprocesy
· Datové toky popisují pohyb informačních paketů nebo fyzických materiálů mezi jednotlivými částmi systému. Datové toky jsou pojmenovány podle toho jaká data přenášejí. Některé datové toky nemusí být pojmenovány, pokud je zřejmé jaká data přenášejí. Typicky to jsou datové toky směřující z nebo do paměti. Šipka znázorňuje směr toku dat. Řídící toky, které neobsahují žádná data se zakreslují přerušovanou čarou.
· Paměti jsou pasivní prvky systému, kde se data ukládají pro pozdější zpracování. Povolené operace jednoho datového toku nad pamětí jsou buď nedestruktivní čtení, zápis, modifikace nebo mazání.
Pravidla a doporučení tvorby DFD:
· Protože analytik nemůže měnit obsah terminátorů nebo způsob jakým pracují a paměti jsou pasivní prvky systému, tak se na DFD nemůže objevit přímý datový tok mezi dvěma terminátory, dvěma paměťmi nebo pamětí a terminátorem. Pokud chceme znázornit komunikaci mezi těmito komponentami, musíme mezi ně umístit alespoň jeden proces. S výjimkou komunikace terminátoru s paměti na rozhraní na kontextovém diagramu.
· Na jednom DFD by se z důvodu lepší čitelnosti mělo dodržovat pravidlo 7 ± 2. To znamená, že součet procesů a pamětí by měl být přibližně 7 na každé úrovní DFD.
· Každý proces na DFD by měl být očíslován z důvodu snazší identifikace, toto číslování se přenáší pomocí tečkové notace na nižší úrovně DFD.
· Nesmí existovat proces, který pouze přijímá data (datové toky do tohoto procesu pouze vstupují) a také nesmí existovat proces, který pouze odesílá svá generovaná data (datové toky z tohoto procesu pouze vystupují). V obou případech se většinou jedná o nerozpoznanou externí entitu.
·
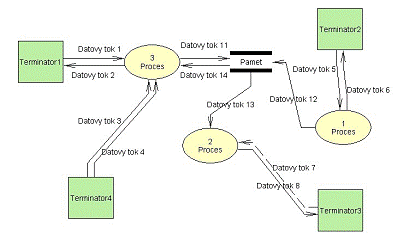 Na
DFD nesmí nastat situace, kdy se z jedné části systému dostaneme do druhé pouze
přes terminátor. Pokud tento případ nastane, tak se systém rozpadá na dva
systémy.
Minispecifíkace
Každý proces na diagramu datových toků (DFD), který není triviální, je dekomponován na nižší úrovní. Pro všechny procesy, které jsou na nejnižší úrovni, existuje právě jedna minispecifikace. Minispecifíkace má za úkol srozumitelně popsat logiku procesů. Popisuje pravidla převodu vstupních datových toků na výstupní datové toky. Minispecifikace nikdy nesmí popisovat vlastní implementaci těchto pravidel, a také nesmí do modelu systému vnášet redundanci žádného druhu.
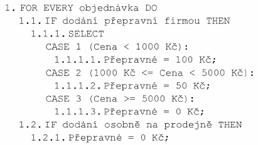 Existuje
několik způsobů zápisu minispecifikace. Jednou z nejpoužívanějších forem je
zápis pomocí strukturované angličtiny. Jedná se o běžný jazyk používající
slovník. Z tohoto jazyka jsou vynechány zbytečné přívlastky, přídavná jména,
složité větné konstrukce, interpunkční znaménka atd. Slovník strukturované
angličtiny je složen z imperativních sloves, pojmů uvedených v Datovém slovníku.
Syntaxe je omezena na jednoduché oznamovací věty a uzavřené rozhodovací a
opakovací konstrukce
Entitně relační diagram (Entity Relationship Diagram - ERD)
ERD je grafický nástroj reprezentující datový model. Pomocí ERD se popisují neměnné atributy struktura a vzájemné vztahy mezi entit-nímy množinami, které není možné zachytit na funkčních modelech.
Komponenty entitně relačních diagramů:
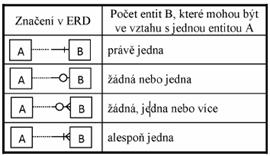
Tvorba ERD se nejčastěji řídí následujícím postupem:
Po pochopení zákazníkovy aplikace se vytvoří iniciální ERD. Poté se začnou přidávat entitní množiny a vztahy mezi nimi s příslušnou aritou. Následuje přidání atributů a označení některých atributů primárními klíči. Dalším krokem je prověrka entit na základě seznamu datových elementů. Předposledním krokem je odstranění entit-ních množin, které mají pouze jedinou entitu, jsou tvořené jenom identifikátorem nebo mají odvozené vztahy. Na závěr se ověří správnost a úplnost vzniklého ERD.
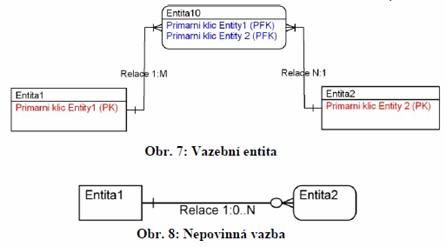
Důležitou činností při tvoření ERD je „normalizace“. Normalizace modelu je sada pravidel, jak postupovat při transformaci struktury entit a relací ERD na strukturu fyzického uspořádání tabulek a relací v databázi. Normalizací se odstraní opakující se data, zjednoduší se relace a zabrání se tzv.
aktualizačním anomáliím, což jsou případy, kdy vymazáním jedné entity smaţeme atributy jiné entity. Normalizace by měla vést k vzniku tabulek, které lze snadno udrţovat a efektivně se na ně dotazovat. Normalizované schéma musí zachovat všechny závislosti původního schématu a relace musí zachovat původní data. To znamená, přirozeným spojením je možné dostat se k původním datům.
Základní stupně normalizace:
1. normální forma (1.NF) - Relace je v první normální formě, pokud kaţdý její atribut obsahuje jen atomické hodnoty. Tedy hodnoty z pohledu databáze jiţ dále nedělitelné. Například v relaci obsahující data o nějaké osobě je více telefonních čísel. V takovéto tabulce by se problematicky prováděly změny čísel, případně vyhledávání podle telefonního čísla. Aby tabulka byla v 1NF, musí se oddělit telefonní čísla do samostatné tabulky.
2. normální forma (2.NF) - Relace se nachází v druhé normální formě, jestliţe je v první normální formě a každý neklíčový atribut je plně závislý na primárním klíči, a to na celém klíči. To znamená, že 2. normální forma se řeší pouze v případě, že existuje vícehodnotový primární klíč. Příklad: Učitelé učí předmět. Klíčem této relace je kombinace atributů Příjmení učitele a Předmět. Telefon ovšem není závislý na celém klíči, ale pouze na atributu Příjmení učitele. Pokud by učitel změnil telefon, musel by se změnit v několika řádcích tabulky. Řešením je opět rozpad na dvě tabulky.
3. normální forma (3.NF) - Relace je v 3. NF, pokud je ve 2. NF a všechny neklíčové atributy jsou navzájem tranzitivně nezávislé. Tranzitivní závislost je taková závislost, mezi minimálně dvěma atributy a klíčem, kde jeden atribut je funkčně závislý na klíči a druhý atribut je funkčně závislý na prvním.
Datový slovník
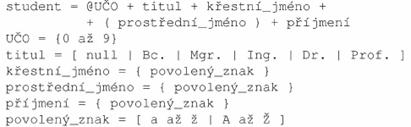
Datový slovník je organizovaný a centralizovaný seznam všech datových prvků systému. Skládá se z popisu dat v datových tocích a pamětech použitých na DFD a také z entit a atributů, které jsou zobrazeny na ERD. Pokud je při analýze použit i jiný modelovací nástroj, např. STD, tak i jeho objekty jsou popsány v datovém slovníku. Datový slovník může být vytvářen ručně, např. ve formě tabulky, nebo automaticky na základě popisů složek grafických modelů v CASE nástroji
 Datové
prvky mohou být v datovém slovníku popsány buď elementárně nebo složené.
Elementární popis představuje přípustný obor hodnot. Složený popis představuje
odkaz na jiné elementární nebo složené složky, které se mohou opakovat nebo
nevyskytovat vůbec. Operátory, které se k tomuto zápisu používají, shrnuje
následující obrázek.