Dotazovací jazyk XQuery
Vztah XPath a XQuery. Konstruktory (přímé, počítané), výraz FLOWER a jeho klauzule. Hodnotové, obecné a uzlové operátory porovnání. Kvantifikátory every a some, in. Obdoba z SQL: vnější a vnitřní spojení, GROUP BY.
1 XQuery
Existuje mnoho v dnešní době již nepoužívaných jazyků (XQL, XML-QL, Quilt) pro dotazovaní nad XML daty. V předchozím tématickém bloku jsme si představili jazyk XPath, konkrétně jeho verzi XPath 1.0, která je v současné době nejpoužívanějším dotazovacím jazykem nad XML daty. Vznikají i nové dotazovací jazyky jako je XPath 2.0 nebo XQuery. Jazyku XQuery bude věnován tento tématický blok.
Jazyk XQuery je nadmnožinou jazyka XPath 2.0, každý dotaz jazyka XPath 2.0 je i dotazem v jazyce XQuery. Mezi jazyky XPath 1.0 a XPath 2.0 neplatí zpětná kompatibilita, lze vyrobit dotaz, který je dotazem v XPath 1.0 a není dotazem v XPath 2.0. Drtivá většina dotazů jazyka XPath 1.0 je však i dotazy jazyka XPath 2.0, tedy jsou i dotazy jazyka XQuery.
XQuery je funkcionální jazyk, každý dotaz v tomto jazyku je výrazem. Výrazy lze libovolně kombinovat. Před vlastním dotazem může nepovinně předcházet deklarace jemných prostorů a definice funkcí.
V SQL Serveru můžeme využívat XQuery dotazy jako parametry funkcí query, exist a value, které lze použít na sloupcích datového typu XML. Více o této problematice pojednává kapitola 2, tématického bloku č. 5. Některé syntaktické konstrukce jazyka XQuery, které se v tomto tématickém bloku ukážeme, nejsou v SQL Serveru podporovány.
Typy výrazů, které lze v XQuery použít:
· XPath výrazy = //katalog/kniha[autor=”Jamie Oliver”]
· Konstruktory = element kniha {element autor}
· FLWOR výrazy = FOR ... LET ... WHERE ... ORDER BY ... RETURN
· Podmíněné výrazy = IF ... THEN ... ELSE
XPath výrazy (1. příklad) známe z předchozího tématického bloku. Déle můžeme použít konstruktory (2. příklad) pomocí kterých vytvoříme nové elementy. FLWOR výraz (3. příklad) je obdoba příkazu SELECT z jazyka SQL. Lze použít i podmíněné výrazy včetně else větve (4. příklad).
Další typy výrazů:
· Kvantifikátory
o EVERY var IN expr SATISFIES expr
o SOME var IN expr SATISFIES expr
· Operace s typy = TYPESWITCH typeexpr CASE ... DEFAULT
· Operátory a funkce = x + y, z = x, fce(x,y,z)
· Proměnné a konstanty $x, “Novák”, 256
· Porovnávání
·
V prvním příkladě vidíme použití všeobecného (every) a existenčního kvantifikátoru (some). V druhém příkladě vidíme vícenásobné podmíněné větvení typeswitch dle typu výrazu. V jednotlivých návěštích case jsou ošetřeny případy, kdy testovaný výraz je elementem daného typu. Ve třetím příkladě vidíme použití aritmetických operátorů a volání funkcí s parametry. Ve čtvrtém příkladě je použití proměnné (znak dolar $ následovaný názvem proměnné), řetězcové konstanty v uvozovkách a číselní konstanty.
1.1 Konstruktory
Konstruktory slouží k vytváření nových elementů, mohou být přímé nebo počítané. Počítané konstruktory se vytvářejí uvedením klíčového slova element následovaného názvem elementu a složenými závorkami, ve kterých je uveden obsah elementu. Přímé konstruktory vytvářejí element pomocí počáteční a koncové značky, mezi kterými je uzavřen obsah elementu. Složené závorky se používají pro uzavření dotazu, který tvoří obsah elementu.
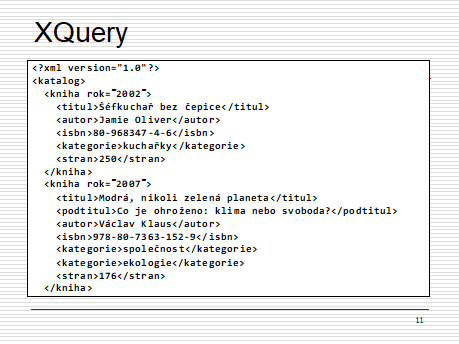
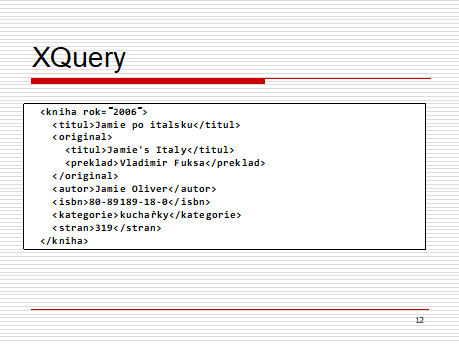
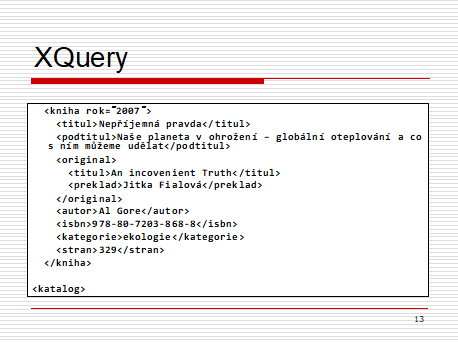
Na slajdech č. 11 – 13 vidíme XML dokument, který bude použit při dotazech v rámci celého tématického bloku. Kořenový element katalog obsahuje 4 elementy kniha.
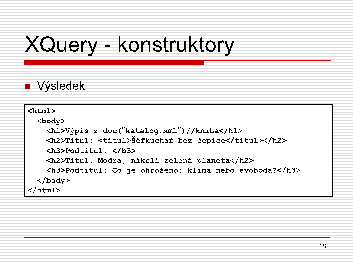
Na slajdu č. 17 vidíme použití přímého konstruktoru, na slajdu č. 18 vidíme použití počítaného konstruktoru. Oba dva příklady vyrobí shodný XML dokument, který je znázorněn na slajdu č. 19.
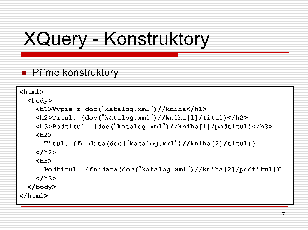
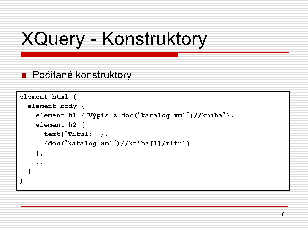
Kromě použití konstruktorů si na příkladech můžeme všimnout použití XPath výrazů pro nalezení požadovaných elementů. XPath výrazy jsou uzavřeny ve složených závorkách a začínají příkazem doc, který jako svůj parametr používá název XML dokumentu, který bude pro daný dotaz použit. Za tímto příkazem následuje vlastní XPath výraz.
Výsledky XPath výrazů jsou celé elementy. Pokud chceme získat pouze samotný obsah těchto elementů, musíme výsledek XPath výrazu použít jako parametr funkce fn:data. Lze použít i funkci bez uvedení jmenného prostoru data. V prvním elementu h2 tato funkce použita není, v druhém elementu h2 použita již je. Rozdíl si lze prohlédnout na slajdu č. 19.
1.2 FLWOR
Výraz FLWOR (vyslovujeme flower) je základní konstrukcí jazyka XQuery, jedná se o kombinaci SQL příkazu SELECT a for cyklu z procedurálních jazyků. Výraz FLWOR se skládá z pěti klauzulí for, let, where, order by a return, z toho jsou povinné pouze klauzule for a return.
o Klauzule order by (order by expr) (FLWOR)
třídí n-tice, které prošly filtrem klauzule where podle daného kritéria
o Klauzule return (return expr) (FLRWOR)
závěrečná klauzule, ve které je zkonstruován výsledek výrazu ze získaných n-tic
Klauzule for je obdobou klauzule FROM z SQL příkazu SELECT. Syntax: klíčové slovo for je následováno názvem proměnné $var, klíčovým slovem in a výrazem expr. Nejprve je vyhodnocen výraz expr, jehož výsledkem je seznam n-tic (zdroj dat pro celý FLWOR výraz). Tyto n-tice se postupně přiřazují do řídící proměnné cyklu $var (obdoba for cyklu z procedurálních jazyků) a pro každou hodnotu proměnné proběhne jedna iterace cyklu.
Klauzule let umožňuje definovat a inicalizovat proměnné, které mohou být použity v dalších částech FLWOR výrazu. Syntax: klíčové slovo let je následování názvem proměnné $var, operátorem přiřazení := a výrazem expr. Nejprve se vyhodnotí výraz expr a jeho hodnota se přiřadí do proměnné $var. Přiřazení hodnoty probíhá v každé iteraci cyklu.
Klauzule where umožňuje z dalšího zpracování vyřazovat n-tice (hodnoty řídící proměnné cyklu), které nesplňují zadanou podmínku. Syntax: klíčové slovo where je následováno výrazem expr, který bude vyhodnocován v každé iteraci cyklu.
Klauzule order by umožňuje setřídit n-tice, které vyhověli podmínce v klauzuli where, podle zadaného výrazu. Syntax: klíčová slova order by jsou následována výrazem expr, který určuje třídící kritérium.
Klauzule return konstruuje výsledek dotazu z n-tic, které vyhověli podmínce v klauzuli where. N-tice jsou setříděny klauzulí order by. Syntax: klíčové slovo return je následováno výrazem expr, který vytváří část XML dokumentu, ve kterém jsou použity získané n-tice.
Na slajdu č. 22 je příklad dotazu využívající výraz FLWOR. Jsou použity všechny klauzule s výjimkou klauzule let. Řídící proměnnou cyklu je $kniha do které postupně dosazujeme hodnotu všech nalezených elementů kniha v daném dokumentu. V podmínce testujeme hodnotu podelementu řídící proměnné $kniha na nerovnost s konstantou. Třídění probíhá podle hodnoty atributu řídící proměnné. Výsledkem výrazu je nový element kniha, který bude obsahovat podelementy titul a autor z původního elementu kniha.
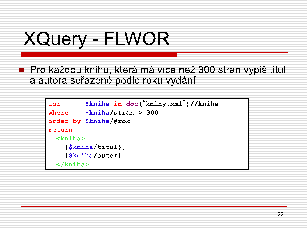
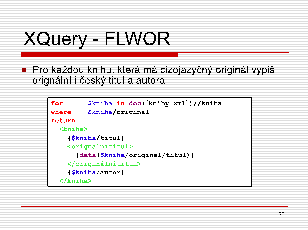
Na slajdu č. 23 vidíme upravený dotaz z předchozího slajdu. V podmínce testujeme existenci podelementu originál. Ve výsledku, v elementu kniha, navíc vytváříme nový podelement originálnítitul.
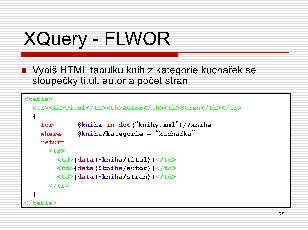
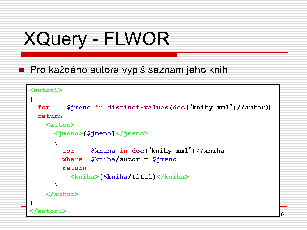
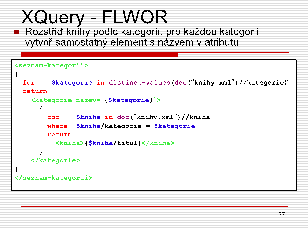
Na slajdu č. 25 vidíme převod výsledku dotazu nad XML dokumentem na tabulku ve formátu HTML. FLWOR výraz je použit jako obsah elementu table. Na slajdu č. 26 vidíme, jak lze obrátit pořadí zanoření elementů kniha a autor. Použijeme FLWOR výraz s dalším zanořeným FLWOR výrazem v klauzuli return. Na slajdu č. 27 vidíme seskupení dat podle kategorií (analogie GROUP BY z SQL), opět použijeme FLWOR výraz s dalším zanořeným FLWOR výrazem v klauzuli return. Ve vnořeném výrazu bude probíhat test na kategorii.
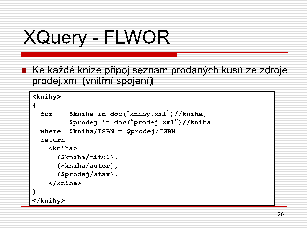
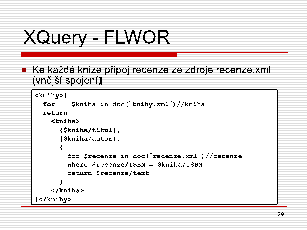
Na slajdu č. 28 je provedeno vnitřní spojení (analogie vnitřního spojení v SQL) dvou XML dokumentů, spojovací podmínka je v klauzuli where. Na slajdu č. 29 je provedeno vnější spojení (analogie vnějšího spojení v SQL) dvou XML dokumentů pomocí vnořeného FLWOR výrazu v klauzuli return.
1.3 Podmíněné výrazy, kvantifikátory, funkce
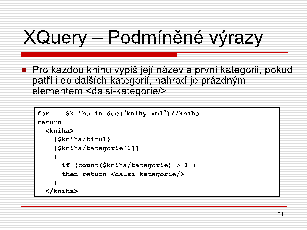
Podmíněný výraz se skládá z klauzulí if, then a else. Každá klauzule obsahuje výraz. Nejprve se vyhodnocuje výraz v klauzuli if, pokud je splněn, výsledkem podmíněného výrazu je výsledek výrazu uvedeného v klauzuli then. Pokud je výraz v klauzuli if nesplněn, výsledkem podmíněného výrazu je výsledek výrazu uvedeného v klauzuli else.
Příklad na použití podmíněného výrazu vidíme na slajdu č. 31. Oproti požadavkům normy zde chybí else větev, příklad obsahuje chybu.
Syntax všeobecného (every) a existenčního kvantifikátoru (some):
o Klauzule every/some (every/some var in expr)
vhodnotí výraz expr a požaduje aby každá/nějaká n-tice ve výsledku splňovala podmínku
o Klauzule satisfies (satisfies expr)
expr je podmínka kvantifikátoru
Tyto kvantifikátory testují, zda každá (every) nebo alespoň jedna (some) proměnná z dané posloupnosti (uvedené za in) splňuje danou podmínku (uvedenou za satisfies).
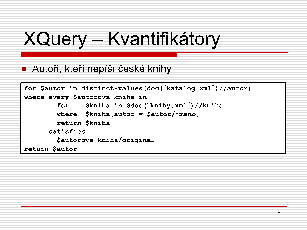 Na
slajdu č. 34 vidíme použití kvantifikátoru v
every v podmínce
where
výrazu FLWOR. Posloupnost uvedená v kvantifikátoru za
in
je tvořena vnořeným FLWOR výrazem.
Přehled některých funkcí, které můžeme v XQuery používat:
o Zabudované funkce
distinct, distinct-value, empty, name, ...
Agregační funkce max, min, avg, count, ...
Další: řetězcové, numerické
... je jich hodně
namespace fn
o Uživatelsky definované funkce
Přímo pomocí syntaxe XQuery
I rekurzivní, typované
Podpora knihoven, rozšiřitelné
Tyto funkce jsou uzavřeny ve jmenném prostoru fn, lze je však použít i bez jeho uvedení.
Jak vytvořit uživatelsky definované funkce: define function name(parameters) as type
Definice funkce začíná klíčovými slovy define function. Následuje název funkce a v kulatých závorkách uvedený seznam parametrů funkce. Parametry se oddělují čárkou. Následuje klíčové slova as, za kterým je uveden typ návratové hodnoty funkce. Tělo funkce je uzavřeno do hranatých závorek [].
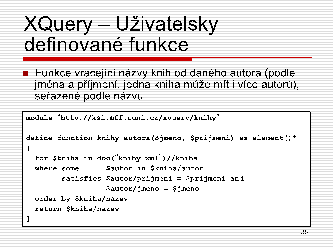
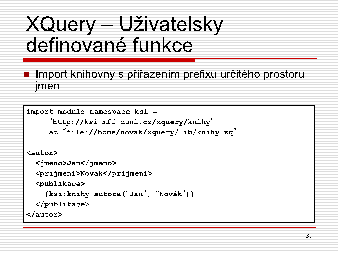
Na slajdu č. 38 vidíme příklad uživatelsky definované funkce, která k zadanému jménu a příjmení, nalezne všechny knihy napsané daným autorem. Návratovou hodnotou funkce může být jeden nebo více elementů kniha. Návratová hodnota funkce je typu element()*. Tělo funkce obsahuje jednoduchý FLWOR výraz. Na slajdu č. 39 vidíme volání této uživatelsky definované funkce pro vytvoření obsahu elementu publikace.
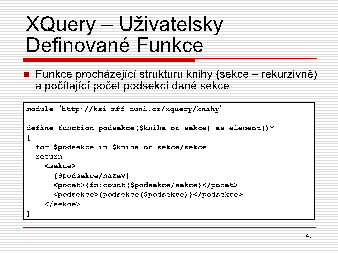
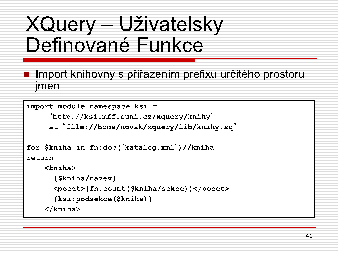
Na slajdu č. 40 vidíme definici uživatelské funkce, která rekurzivně počítá počet podsekcí dané sekce. Všimněme si použití funkce fn:count pro spočtení počtů elementů výsledku výrazu. Na slajdu č. 41 je pak tato funkce použita pro vytvoření obsahu elementu kniha.
1.4 Operátory porovnání
V jazyku XQuery jsou tři typy porovnávacích operátorů: hodnotové, obecné a uzlové. Hodnotové operátory předpokládají, že oba jejich operandy jsou sekvence délky nejvýše jedna (= jedna konkrétní hodnota). Obecné operátory umožňují vzájemné porovnávání sekvencí. Uzlové operátory porovnávají vzájemnou pozici uzlů v dokumentu.
Hodnotové operátory jsou lt (menší), gt (větší), le (menší nebo rovno), ge (větší nebo rovno), eq (rovno), ne (nerovno). Při použití hodnotových operátorů se nejprve provede atomizace (získání hodnoty elementu), následně se operandy konvertují na stejný datový typ a následně se porovnají. Netypované operandy jsou implicitně přetypovány na řetězce. Pokud je některý z operandů sekvence délky větší něž jedna, je vyvolána chyba. Pokud je jeden z operandů prázdná sekvence, výsledkem porovnání je prázdná sekvence.
Výsledky několika porovnání pomocí hodnotového operátoru le (menší nebo rovno):
o 1 le 2 => true
o (1) le (2) => true
o (1) le (2,1) => chyba
o (1) le () => ()
o <a>5</a> eq <b>5</b> => true
o $kniha/autor eq “Jamie Oliver”
=> true pouze pokud $book má právě jeden podelement autor s hodnotou “Jamie Oliver”
Na pátém řádku vidíme porovnání dvou elementů se shodným obsahem. Na šestém řádku vidíme porovnání výrazu, který může vracet element nebo elementy. Pokud je výsledkem výrazu více elementů, dojde k chybě. Pokud je výsledkem jen jeden element, rozhoduje hodnota, kterou obsahuje.
Obecné operátory jsou < (menší), > (větší), <= (menší nebo rovno), >= (větší nebo rovno), = (rovno), != (nerovno). Při použití obecných operátorů se opět provede jako první atomizace při které vzniknou sekvence atomických hodnot. Následně se hledá položka levého operandu, která by splňovala podmínku danou operátorem pro některou z položek pravého operandu. Pokud je taková položka nalezena, výsledkem porovnání je true. Pokud taková položka není nalezena, výsledkem porovnání je false.
Při hledání operandů, které budou splňovat podmínku danou porovnávacím operátorem dochází k datovým konverzím. Pokud jsou oba operandy netypové, převedou se na řetězce. Pokud je jeden operand netypovaný a druhý numerický, provede se konverze na typ double.
Několik příkladů na použití obecných operátorů:
o 1 < 2 => true
o (1) < (2) => true
o (1) < (2,1) => true
o (1) < () => false
o (0,1) = (1,2) => true
o (0,1) != (1,2) => true
o $kniha/autor = “Jamie Oliver”
=> true pokud $book má nějaký podelement autor s hodnotou “Jamie Oliver”
Na třetím řádku porovnáváme jednoprvkovou sekvenci (1), zda je menší než dvouprvková sekvence (2,1). Protože v dvouprvkové sekvenci se nachází prvek 2, který je větší než prvek 1 z jednotkové sekvence, nerovnost je splněna.
Na 5. a 6. řádku porovnáváme dvě sekvence (na obou řádcích stejné) pomocí operátoru rovnosti (5. řádek) a nerovnosti (6. řádek). Výsledek je v obou případech true, protože v levé sekvenci se v obou případech nalezl prvek, který byl v požadovaném vztahu k nějakému prvku z pravé sekvence. Na 5. řádku se jedná o vztah 1=1, na 6. řádku se jedná například o vztah 0!=2.
Uzlové operátory jsou is, << a >>. Pokud je některý z operandů prázdná sekvence, výsledkem porovnání je prázdná sekvence. Pokud je některý z operandů sekvence délky větší než 1, je vyvolána chyba.
Výsledek porovnání operátorem is je true, pokud oba operandy jsou tentýž uzel dokumentu. Příklad použití:
/katalog/kniha[isbn=”80-968347-4-6”] is /katalog/kniha[titul=”Jamie Oliver”]
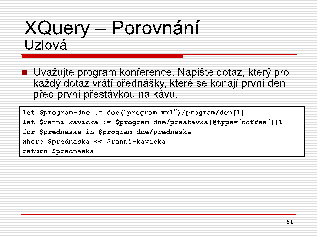
Výsledek porovnání operátorem << je true, pokud levý operand je uzlem, který se nachází v dokumentu před uzlem, který je pravým operandem. Výsledek porovnání operátorem >> je true, pokud levý operand je uzlem, který se nachází v dokumentu za uzlem, který je pravým operandem. Příklad použití je uveden na slajdu č. 51.