dotazovací jazyk sql
Dotaz, atribut, záznam. Typy příkazů (manipulace s tabulkou, záznamem). Klauzule příkazu SELECT. Agregační funkce. Klíčová slova ALL, DISTINCT, *, LIKE, EXISTS, IN, ANY, ALL. Kartézský součin, přirozené spojení, vnitřní a vnější spojení.
Dotaz, Dotazovací jazyk SQL, slovník pojmů
Dotazovací jazyk SQL (structured query language) se používá pro práci s daty uloženými v relačních databázích (například v SQL Serveru). Jazyk SQL není case-sensitive, nerozlišuje velikost písmen. Přesto bývá dobrým zvykem odlišovat klíčová slova jazyka SQL od zbytku zdrojového kódu, tím že je budeme psát velkými písmeny.
· Dotaz =
· Atribut = sloupec v tabulce
· Záznam = řádek v tabulce
Typy příkazů
Jazyk SQL obsahuje čtyři hlavní skupiny příkazů:
· pro definici dat
· pro manipulaci s daty
· pro řízení přístupových práv
· pro řízení transakcí
Příkazy pro definici dat
Jazyk SQL umožňuje definovat databázové objekty (tabulky, pohledy, indexy, uložené procedury, …). Pomocí příkazu CREATE lze objekty vytvářet, pomocí příkazu ALTER modifikovat a pomocí příkazu DROP rušit (mazat).
Příkazy pro manipulaci s daty
Patří sem příkazy SELECT pro zobrazení dat, INSERT pro vložení dat, UPDATE pro modifikaci dat a DELETE pro smazání dat.
Příkaz SELECT
Tabulka obsahuje řádky (záznamy) a sloupce (atributy). Sloupce se definují při vytváření tabulky pomocí příkazu CREATE. Při vkládání dat do tabulky pomocí příkazu INSERT vkládáme řádky, které musejí odpovídat podmínkám nadefinovanými pro danou tabulku (integritní omezení).
Pomocí příkazu SELECT pokládáme databázi dotaz, jehož výsledkem je multimnožina řádků. Multimnožina řádků nemá definované uspořádání prvků (řádků) a navíc se v ní shodné prvky (řádky) mohou opakovat. Příkaz SELECT obsahuje nejméně dvě klauzule (SELECT, FROM), ke kterým lze přidat ještě tři nepovinné klauzule (WHERE,.GROUP BY, HAVING).
· Select => následuje seznam polí, které budou ve výstupu
· From => na které tabulky se dotazujeme
· Where => podmínka, kterou musí záznam splňovat, aby byl ve výsledku
· Group by => seznam sloupců, podle kterých se bude výstup agregovat
· Having => podmínka, kterou musí agregovaný záznam splňovat, aby byl ve výsledku (analogicky jako where, ale aplikuje se až po agregaci)
Jednoduchým příkladem dotazu využívajícím pouze klauzule SELECT a FROM může být vypsání všech řádků (záznamů) uložených v jedné tabulce. Složitější dotaz může využívat informací z více tabulek, které vhodným způsobem spojíme. Klauzule SELECT specifikuje výrazy (například jména sloupců), jejichž hodnoty se mají objevit ve výsledku. Klauzule FROM určuje tabulku či tabulky, ze kterých čerpáme data. Přidáním klauzule WHERE ponecháme ve výsledku pouze ty řádky, které vyhovují námi zadané podmínce. Nepovinná klauzule GROUP BY určuje přes které výrazy (například sloupce) se provede agregace dat. Klauzule GROUP BY může být doplněna klauzulí HAVING, pomocí které lze stanovit podmínku na agregovaný řádek, při jejímž splnění bude daný řádek zařazen do výsledku.
Odpovědi (multimnožiny řádků) získané příkazem SELECT lze dále zpracovat pomocí množinových operací sjednocení (UNION), průnik INTERSECT a rozdíl EXCEPT. Výsledky těchto množinových operací jsou množiny, přestože na vstupu mohly být multimnožiny.
Klauzule SELECT a FROM
Klauzule SELECT a FROM jsou povinné části každého dotazu. Klauzule SELECT specifikuje výrazy (například jména sloupců), jejichž hodnoty se mají objevit ve výsledku. Klauzule FROM určuje tabulku či tabulky, ze kterých čerpáme data.
Ihned za klíčovým slovem SELECT může následovat jedno z klíčových slov ALL nebo DISTINCT. Při použití ALL je výsledkem dotazu multimnožina, při použití DISTINCT je výsledkem dotazu množina (odstraní se druhé a další výskyty duplicitních řádků). Pokud explicitně neuvedeme ani jedno z těchto klíčových slov, implicitně je použito ALL.
Příklad: Mějme tabulku Zaměstnanci se sloupci Jméno a Příjmení typu řetězec. V tabulce Zaměstnanci jsou záznamy (Petr, Novák), (Petr, Novák) a (Jan, Dvořák). Při vypsání tabulky příkazem SELECT Jméno, Příjmení FROM Zaměstnanci je nám vrácen výsledek obsahující tři řádky (řádek (Petr, Novák) tam bude dvakrát). Při vypsání tabulky příkazem SELECT DISTINCT Jméno, Příjmení FROM Zaměstnanci je nám vrácen výsledek obsahující pouze dva řádky (Petr, Novák) a (Jan, Dvořák).
V klauzuli SELECT dále následuje čárkou oddělovaný seznam výrazů, které bude obsahovat výsledek dotazu. Těmito výrazy mohou být mohou být konstantní výrazy nebo sloupce některé z tabulek uvedené v klauzuli FROM. Na výrazy zde uvedené lze navíc aplikovat agregační funkce (COUNT, SUM, MAX, MIN, AVG), případně z nich vytvořit aritmetické výrazy (sečtení hodnot dvou výrazů, vynásobení hodnoty výrazu konstantou, atd.).
Seznam výrazů uvedený v klauzuli SELECT lze úplně nahradit (nebo jen rozšířit) symbolem *, který do výsledku zařadí všechny sloupce tabulek uvedených v klauzuli WHERE. Symbol * lze použít nejen samostatně ale i jako argument agregačních funkcí.
Agregační funkce
Agregačním funkcím lze předat jako parametr konkrétní výraz (například sloupec), funkci COUNT navíc ještě symbol * zastupující celý řádek odpovědi dotazu. Ke spočtení počtu řádek zpracovávaného dotazu se obvykle používá COUNT(*). Ke spočtení počtu unikátních hodnot v daném sloupci se používá COUNT(DISTINCT sloupec). Agregační funkce umějí počítat součet (funkce SUM), průměr (funkce AVG), minimum (funkce MIN) a maximum (funkce MAX) z hodnot daného výrazu (sloupce) přes všechny řádky zpracovávaného dotazu.
Klauzule FROM udává zdroje, ze kterých se čerpají data pro dotaz. Kromě tabulek zde mohou být uvedeny i pohledy (view) nebo vnořené dotazy (subquery, subselect). Jednotlivé zdroje lze oddělit čárkou, pak se použije jejich kartézský součin, nebo je lze spojit pomocí klíčových slov (např. JOIN).
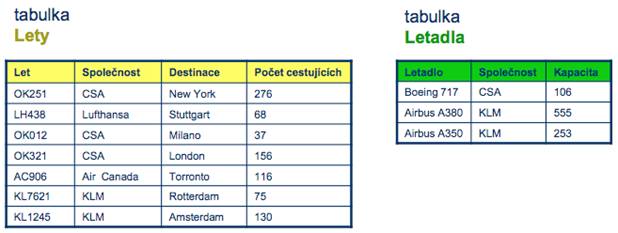
Na obrázku jsou dvě tabulky, které budeme využívat v našich příkladech. V tabulce Letadla je ke každému z letadel uvedena letecká společnost, které letadlo patří a kapacita letadla, kolik cestujících je schopno přepravit. V tabulce lety je uveden kód letu, letecká společnost, která ho provozuje, destinace, do které let směřuje, a počet cestujících.
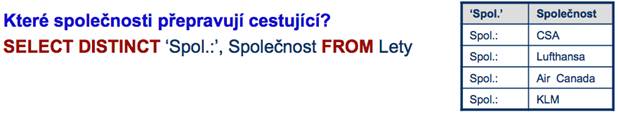
Dále jsou předvedeny dva dotazy. První z dotazů demonstruje využití klíčového slova DISTINCT pro vrácení unikátních výskytů leteckých společností v tabulce Lety. Tento příklad demonstruje i použití konstantního výrazu 'Spol.‘ jako hodnoty sloupce ve výsledku dotazu.
Kartézský součin
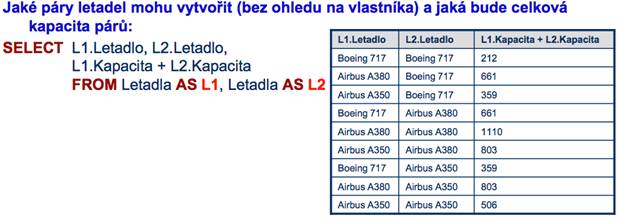
Druhý dotaz demonstruje použití kartézského součinu dvou tabulek v klauzuli FROM. Protože chceme provést kartézský součin tabulky Letadla sama se sebou, je nutné nejméně jeden z jejich výskytů pro potřeby dotazu přejmenovat za pomocí klíčového slova AS. V našem příkladu jsme přejmenovali oba výskyty tabulky Letadla. První výskyt jako L1, druhý jako L2. Na jednotlivé sloupce se potom odkazujeme pomocí nového identifikátoru (L1 nebo L2), tečky a jména sloupce.
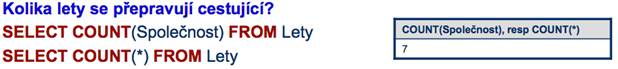
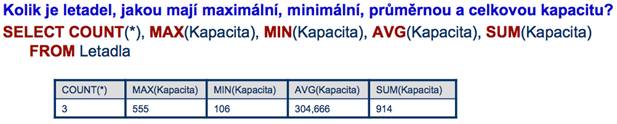
Dále jsou předvedeny tři dotazy, které využívají agregační funkce. V prvním z dotazů je použita funkce COUNT v kombinaci s klíčovým slovem DISTINCT pro zjištění počtu unikátních hodnot ve sloupci zpracovávaného dotazu. Druhý z příkladů demonstruje, že funkci COUNT bez použití klíčového slova DISTINICT lze předat jako parametr * nebo libovolný sloupec zpracovávaného dotazu a výsledek je v obou případech shodný. Třetí z příkladu demonstruje použití všech agregačních funkcí v jednom dotazu.

Klauzule WHERE
Klauzule WHERE je nepovinou součástí dotazu. Při jejím použití ve výsledku dotazu ponecháme pouze ty řádky, které vyhovují námi zadané podmínce. Podmínky lze slučovat pomocí běžných logických operátorů (AND, OR, NOT)
Podmínku lze vytvořit následujícími pravidly:
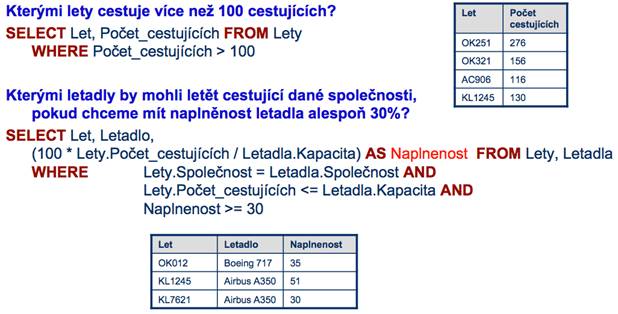
· První z dotazů demonstruje porovnání hodnoty sloupce s konstantou (pravidlo č. 1).
· V druhém z dotazů si nejprve v klauzuli SELECT vytvoříme nový výraz Naplněnost (označen červeně). Klauzule FROM obsahuje dvě tabulky, jejich spojení podle sloupce Společnost dosáhneme v první částí podmínky uvedené v klauzuli WHERE. Druhá část podmínky testuje, zda dané letadlo má dostatečnou kapacitu pro příslušný let. Třetí část podmínky testuje dostatečnou naplněnost letu, pomocí porovnání výrazu Naplněnost s konstantou.
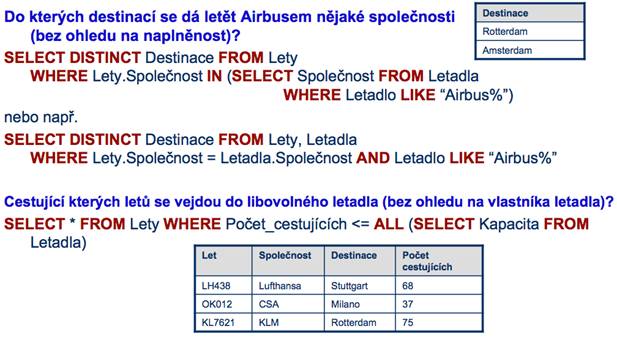
· Pomocí predikátu LIKE (pravidlo č. 3) testujeme hodnotou sloupce, zda obsahuje hledaný podřetězec. V dotazu jsme potřebovaly využít data ze dvou tabulek. V prvním zápisu dotazu jsme použili predikát IN (pravidlo č. 5) a vnořený dotaz. V druhém zápisu dotazu jsme použili spojení dvou tabulek.
· Dotaz dole demonstruje použití predikátu ALL (pravidlo č. 8) a vnořeného dotazu.
Spojení tabulek
V klauzuli FROM specifikujeme tabulky (případně pohledy či vnořené dotazy), ze kterých čerpáme data. Pro jednoduchost budeme uvažovat pouze tabulky. Pokud jsou v klauzuli FROM uvedeny alespoň dvě tabulky, musíme vybrat způsob jakým je navzájem spojíme. Na výběr máme mezi kartézským součinem, přirozeným spojením, vnitřním a vnějším spojením.
Jednotlivé pojmy této kapitoly si budeme vysvětlovat na následujícím příkladu: Mějme tabulku T1 se sloupci A a B typu celé číslo a tabulka T2 se sloupci A a C typu celé číslo. V tabulce T1 jsou záznamy (1,1), (1,2), (2,3) a (3,5). V tabulce T2 jsou záznamy (1,1), (1,3), (2,4) a (4,6). Viz obrázek 2.
|
T1 |
|
T2 |
||
|
A |
B |
A |
C |
|
|
1 |
1 |
1 |
1 |
|
|
1 |
2 |
1 |
3 |
|
|
2 |
3 |
2 |
4 |
|
|
3 |
5 |
4 |
6 |
|
Obrázek 2: Tabulka T1 a T2
Kartézský součin spojí každý řádek z první tabulky s každým řádkem z druhé tabulky. Pokud má první tabulka n1 řádků a druhá tabulka n2 řádků, výsledek bude mít n1*n2 řádků. V našem případě kartézský součin tabulek T1 a T2 bude mít 16 řádků. Syntax: Tabulky jsou spojeny kartézským součinem, pokud je oddělíme čárkou, nebo mezi ně napíšeme klíčová slova CROSS JOIN. Náš příklad: SELECT * FROM T1, T2 nebo SELECT * FROM T1 CROSS JOIN T2).
Přirozené spojení je speciální druh vnitřního spojení (viz dále). V tabulkách T1 a T2 vyhledáme sloupce S1, …, Sn se shodnými názvy a datovými typy v obou tabulkách. Obvykle se jedná o primární klíč jedné tabulky a cizí klíč druhé tabulky. Do výsledku jsou zařazeny pouze ty dvojice řádků (z kartézského součinu), které mají shodné hodnoty ve sloupcích shodného názvu a typu (platí ("k=1...n) T1.Sk = T2.Sk). Syntax: Tabulky jsou spojeny přirozeným spojením, pokud mezi ně napíšeme klíčová slova NATURAL JOIN. Vnitřní spojení není v SQL Serveru 2005 implementováno.
V případě tabulek T1 a T2 z našeho příkladu se jedná o společný sloupec A. Přirozeným spojením (SELECT * FROM T1 NATURAL JOIN T2) získáme 5 řádků (1,1,1,1), (1,2,1,1), (1,1,1,3), (1,2,1,3) a (2,3,2,4).
Dalším způsobem spojení tabulek je vnitřní spojení. Výsledkem vnitřního spojeni tabulek T1 a T2 jsou ty řádky z kartézského součinu, které splňují spojovací podmínku (stejnou jaká může být v klauzuli WHERE – slajd č. 13) danou vnitřním spojením. Tato podmínka bývá obvykle rovností primárního klíče z jedné tabulky s cizím klíčem z druhé tabulky.
Syntax: Tabulky jsou spojeny vnitřním spojením, pokud mezi ně napíšeme klíčová slova INNER JOIN (V SQL Serveru stačí jen JOIN) a za druhou ze spojovaných tabulek napíšeme klíčové slovo ON, za kterým uvedeme spojovací podmínku. Vnitřní spojení tabulek lze také nahradit kartézským součinem a spojovací podmínku uvést jako jednu z částí podmínky v klauzuli WHERE.
V případě tabulek T1 a T2 je vnitřně spojíme podmínkou na rovnost hodnot ve společném sloupci A. Příkaz SELECT * FROM T1 INNER JOIN T2 ON T1.A=T2.A vrátí stejných pět řádků jaké jsou uvedeny (viz výše) ve výsledku příkladu na přirozené spojení.
Vnější spojení (OUTER JOIN) je tří typů. Plné FULL, levé LEFT a pravé RIGHT. Vnější spojení obsahuje všechny řádky, které by obsahovalo vnitřní spojení. Navíc pro každý řádek z dané tabulky (z levé při LEFT, z pravé při RIGHT) či obou tabulek (při FULL), který není spárován s žádným řádkem z druhé tabulky, je přidána řádek, který má ve sloupcích z druhé tabulky (ze které se nepodařilo nalézt párový řádek) dosazeny hodnoty NULL
Syntax: je podobná jako u INNER JOINU, pouze místo INNER JOIN je uvedeno LEFT OUTER JOIN, respektive RIGHT OUTER JOIN, respektive FULL OUTER JOIN. V SQL Serveru lze klíčové slovo OUTER vynechat.
V našem příkladě s tabulekami T1 a T2 provedeme postupně všechna tři vnější spojení s podmínkou na rovnost hodnot ve společném sloupci A. Příkaz na levé vnější spojení SELECT * FROM T1 LEFT OUTER JOIN T2 ON T1.A=T2.A vrátí stejných pět řádků jaké jsou uvedeny (viz výše) ve výsledku příkladu na přirozené spojení a navíc ještě šestý řádek (3,5, NULL, NULL). Pravé vnější spojení by vrátilo již zmíněných pět řádků a navíc šestý řádek (NULL, NULL, 4,6). Plné vnější spojení by vrátilo již zmíněných pět řádků a navíc oba dva řádky, které byly vráceny navíc při levém a pravém vnějším spojení.
Na slajdu č. 22 vidíme dva příklady na spojení tabulek. Používáme tabulky Lety a Letadla ze slajdu č.14. V prvním příkladě použijeme vnitřní spojení obou tabulek přes rovnost hodnot v jejich společném sloupci Společnost a provedené spojení je navíc ještě omezeno druhou podmínkou na nerovnost hodnot dvou sloupců s číselnými údaji (kapacita letadla, počet cestujících). V klauzuli SELECT je navíc vyroben nový výraz Volnych_mist, podle kterého výsledek dotazu setřídíme s pomocí klauzule ORDER BY.
V druhém dotazu je použito vnější spojení, základ dotazu je stejný jako v prvním příkladě. Naším cílem je v tabulce Lety vyhledat ty řádky, ke kterým neexistuje odpovídající řádek v tabulce Letadla (letecká společnost nevlastní vhodné letadlo pro provozování daného letu). Pomocí levého vnějšího spojení budou mít tyto hledané řádky ve sloupcích tabulky Letadla hodnoty NULL. Pomocí predikátu testujícího hodnotu sloupce na hodnotu NULL, tyto řádky najdeme.
Klauzule GROUP BY a HAVING
V klauzuli GROUP BY je uveden čárkou oddělovaný seznam výrazů, přes které se provede agregace dat. Těmito výrazy mohou být mohou sloupce některé z tabulek uvedené v klauzuli FROM, případně z nich vytvořit aritmetické výrazy (sečtení hodnot dvou výrazů, vynásobení hodnoty výrazu konstantou, atd.). Pro jednoduchost budeme dále pracovat pouze se sloupci.
Nyní si vysvětlíme princip agregace. Předpokládejme, že agregaci provádíme přes N sloupců, které budeme nazývat agregační sloupce (analogicky by byly agregační výrazy). Multimnožina řádků dotazu se rozdělí na podmnožiny. V každé vzniklé podmnožině budou mít všechny řádky shodné hodnoty všech agregačních sloupců. Hodnoty ostatních sloupců se v rámci každé podmnožiny mohou různit. Po aplikaci klauzule GROUP BY se nahradí všechny řádky každé z podmnožin pouze jedním novým agregovaným řádkem. Budeme mít stejný počet agregovaných řádků, jako bylo vzniklých podmnožin. Výsledkem dotazu bude množina agregovaných řádků.
Jak nahradit celou podmnožinu řádků jedním agregovaným řádkem? Jaké bude mít nový agregovaný řádek hodnoty? Řádky v jedné podmnožině mají shodné hodnoty agregačních sloupců, tedy v nově vzniklém agregovaném řádku budou mít tyto sloupce také tyto hodnoty. Problém nastává u neagregačních sloupců, které mohou mít hodnoty různé. Aby mohli být neagregační sloupce zařazeny do dotazu (vyskytnout se v klauzuli SELECT), musí být na ně aplikována některá z agregačních funkcí. Agregační funkce pracuje s hodnotami sloupce pouze v rámci jedné podmnožiny.
Pokud dotaz obsahuje klauzuli GROUP BY, platí výrazná omezení na výrazy uvedené v klauzuli SELECT. Těmito výrazy mohou být mohou být konstantní výrazy nebo výrazy uvedené v klauzuli GROUP BY (agregační výrazy). Případně výrazy vzniklé použitím aritmetických operátorů, které mají oba operandy agregační výraz či konstantu. Na (neagregační) výrazy neuvedené v klauzuli GROUP BY a nepatřící do předchozí skupiny musí být aplikována některé z agregačních funkcí.
Klauzule GROUP BY může být doplněna klauzulí HAVING, pomocí které lze stanovit podmínku na agregovaný řádek, při jejímž splnění bude daný řádek zařazen do výsledku. Podmínky mohou být stejně bohaté jako v případě klauzule WHERE, platí jediné omezení. Neagregační výrazy mohou být použity pouze jako parametr agregačních funkcí.
Příklady: Mějme tabulku T1 se sloupci A, B a C typu celé číslo.V tabulce T1 jsou záznamy (1,1,1), (1,1,2), (1,2,3), (1,2,5), (2,1,3), (2,3,5) a (3,1,5). Ukážeme si dva příklady.
Příklad č. 1.: Provedeme příkaz SELECT A, MAX(B) FROM T1 GROUP BY A. Agregační sloupec je A, který v dotazu nabývá tří různých hodnot: 1, 2 a 3. Řádky dotazu se nám rozdělí do tří podmnožin. V první podmnožině budou řádky (1,1,1), (1,1,2), (1,2,3), (1,2,5), v druhé budou řádky (2,1,3), (2,3,5) a ve třetí bude řádek (3,1,5). Nyní vyrobíme agregované řádky, z každé podmnožiny vznikne jeden. Agregovaný řádek bude obsahovat hodnotu sloupce A v dané podmnožině a maximální z hodnot ve sloupci B v rámci dané podmnožiny. Vzniknou tři agregované řádky: (1,2), (2,3) a (3,1)
Příklad č. 2.: Provedeme příkaz SELECT A, B, COUNT(*), SUM(C) FROM T1 GROUP BY A,B. Agregační sloupce jsou A a B, které v dotazu nabývají pěti různých vzájemných kombinací hodnot (1,1), (1,2), (2,1), (2,3) a (3,1) Řádky dotazu se nám rozdělí do pěti podmnožin. V první podmnožině budou řádky (1,1,1), (1,1,2), v druhé budou řádky (1,2,3), (1,2,5), ve třetí bude řádek (2,1,3), ve čtvrté bude řádek (2,3,5) a v páté bude řádek (3,1,5). Nyní vyrobíme agregované řádky, z každé podmnožiny vznikne jeden. Agregovaný řádek bude obsahovat hodnotu sloupce A v dané podmnožině, hodnotu sloupce B v dané podmnožině, počet prvků dané podmnožiny a součet hodnot ve sloupci C v rámci dané podmnožiny. Vznikne pět agregovaných řádků: (1,1,2,3), (1,2,2,8), (2,1,1,3), (2,3,1,5) a (3,1,1,5).
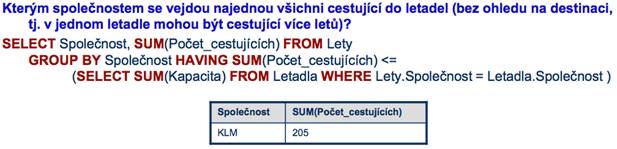
Níže jsou dva příklady použití agregačních funkcí, využíváme tabulky Lety a Letadla. V prvním příkladu máme jeden agregační atribut Společnost a pomocí agregační funkce SUM sčítáme hodnoty sloupce Kapacita v rámci každé podmnožiny, do kterých se řádky dotazu rozdělí.
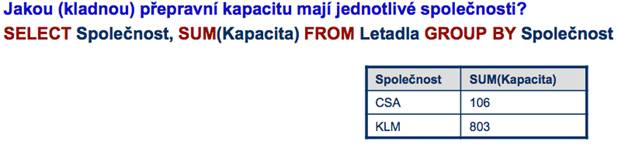
Druhý z dotazů mé také jeden agregační atribut Společnost, podle jehož hodnot se řádky rozdělí do podmnožin. Dotaz využívá klauzuli HAVING, ve které se pro agregovaný řádek porovná výsledek agregační funkce SUM aplikovaný na neagregační sloupec Kapacita s hodnotou vnořeného dotazu.