dotazovací jazyk xpath
XPath, stromový model, cesta, krok, osa (její typy), test uzlu, podmínka. Funkce node(), text(), *, last(), position(), count(). Dotazování nad XML v SQL.
1 XPath
XPath je dotazovací jazyk nad XML dokumenty. Výsledkem dotazů v jazyce XPath je část XML dokumentu. Základní myšlenka tohoto jazyka je založena na pohybu ve stromovitém modelu dokumentu, obdoba pohybu v systému souborů. Dotaz lze chápat jako cestu k určité části XML dokumentu. Na jazyku XPath je založeno mnoho dalších XML technologií, například XQuery či XSLT.
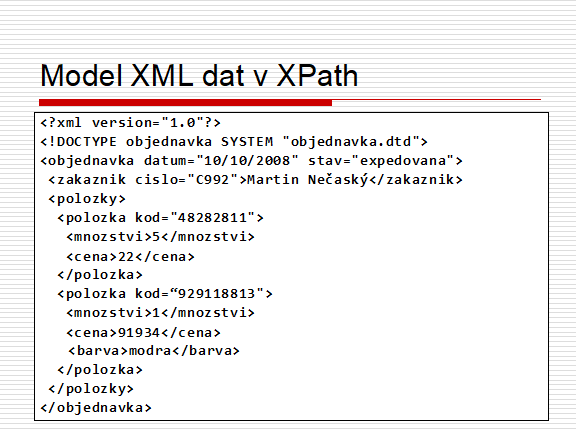
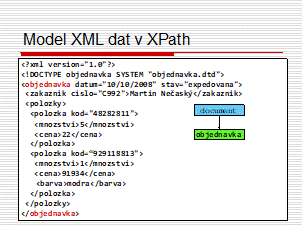
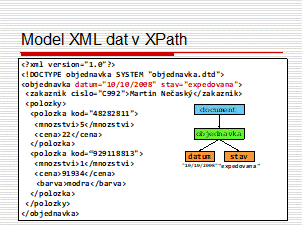
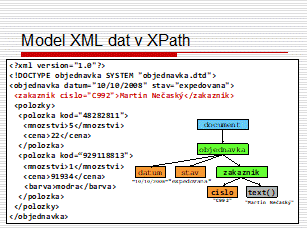
Na prvním slajdu vidíme příklad XML dokumentu, jehož stromový model budeme vytvářet pro účely dotazování v jazyce XPath.. Na dalších slajdech vidíme jak postupně model vzniká. Model je vždy zobrazen v pravé polovině slajdu, červeně označené řádky XML dokumentu jsou aktuálně na daném slajdu do modelu přidávané.
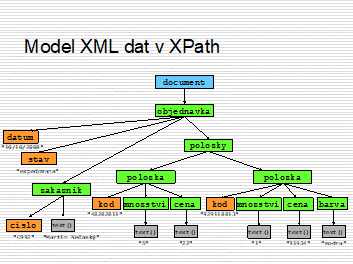
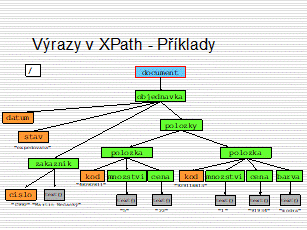
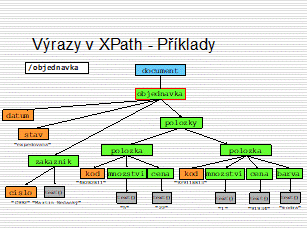
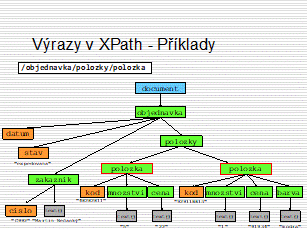
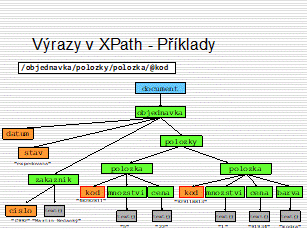
Na slajdu je zobrazen již celý hotový model. Jedná se o strom, ve kterém jsou uzly reprezentující celý dokument, elementy, atributy, nebo textový obsah elementů. Kořen stromu document reprezentuje celý XML dokument a je označen modře, má jediného syna kořenový element dokumentu objednávka. Zelenou barvu mají uzly elementů. Oranžově jsou obarveny uzly atributů, hodnoty atributů jsou uvedeny pod těmito uzly. Šedou barvu mají uzly pro textový obsah, konkrétní text je uveden opět pod těmito uzly.
Model může obsahovat ještě uzly pro komentáře, uzly pro proveditelné konstrukce a uzly pro jmenné prostory, žádný z těchto typů uzlů se však na našem obrázku nenachází. Model neobsahuje sekce CDATA, odkazy na entity a DTD.
Přestože atributy (oranžově označené) v modelu vypadají jako potomkové svých elementů, z hlediska využití tohoto stromu po dotazy v jazyku XPath nejsou jako jejich potomci brány.
1.1 Cesta
Výrazem v jazyce Xpath je cesta, která se skládá s kroků. Cesta může být absolutní (začínající v kořeni stromu) nebo relativní (a k ní musí být známa množina uzlů, ze kterých se má startovat). Jednotlivé kroky cesty se oddělují symbolem lomítka (/) a reprezentují jednotlivé uzly v modelu dokumentu. Návratovou hodnotou cesty je množina uzlů. Výsledek není uspořádán a může být zobrazeno jeho pořadí, které je různé od pořadí elementů v dokumentu.
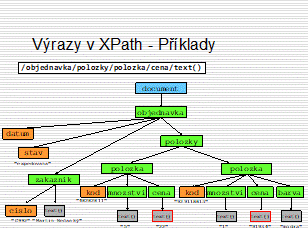
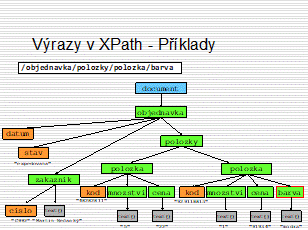
Na slajdech je na stromovém modelu dokumentu znázorněno postupné vyhodnocování cesty /objednavka/polozky/polozka/cena/@kod. Elementy, které jsou právě vyhodnocovány v daném kroku cesty jsou ve stromovém modelu označeny červeným rámečkem.
1.2 Osy
V předchozí kapitole jsme si ukázali, že krokem XPath výrazu je přechod od rodičovského elementu na jeden nebo více elementů, které jsou jeho potomky. Jednalo se pouze o speciální příklad XPath kroku, ve skutečnosti je syntax bohatší.
XPath krok je definován jako osa::test-uzlu podmínka. Osa udává požadovaný vztah hledaných uzlů vzhledem k danému počátečnímu uzlu v rámci stromového modelu XML dokumentu. Test uzlu omezuje množinu konkrétních kandidátů (uzlů) daných konkrétní osou na uzly daného typu a případně názvu. Podmínka pak specifikuje pokročilé požadavky na uzly, které byly vybrány osou a prošly testem uzlu. Podmínek smí být použito i více.
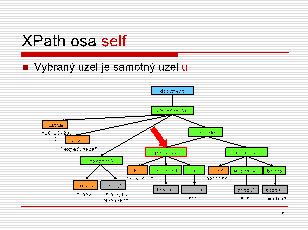
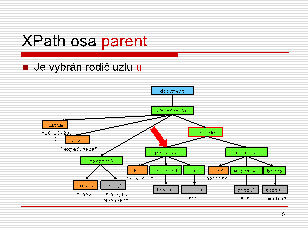
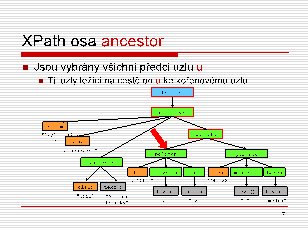
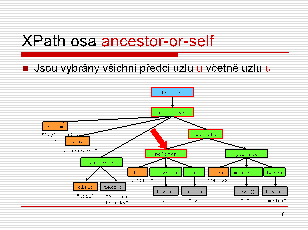
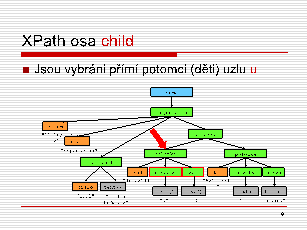
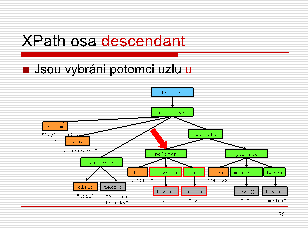
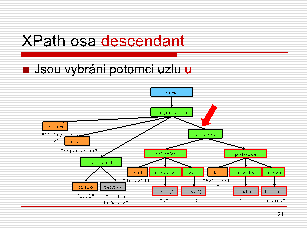
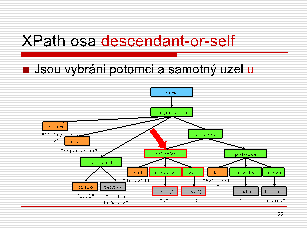
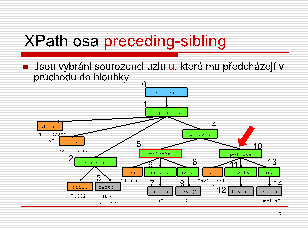
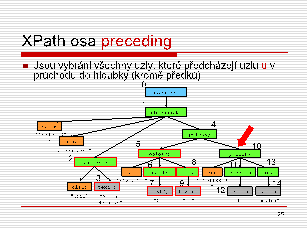
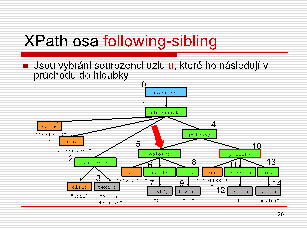
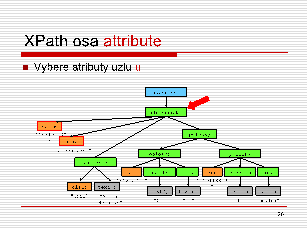
Na slajdech jsou představeny další osy. Červenou šipkou je označen uzel (budeme mu říkat uzel u), pro který se daný krok cesty vyhodnocuje. Červenými rámečky jsou označeny uzly, které jsou výsledkem daného kroku dotazu.
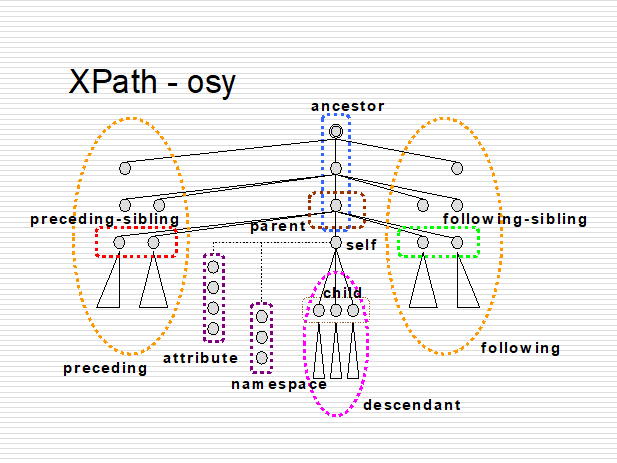
Výsledkem použití osy self je samotný uzel u. Výsledkem použití osy parent je rodič uzlu u. Výsledkem použití osy ancestor jsou všichni předci uzlu u, tedy všechny uzly ležící na cestě od kořene k uzlu u. Výsledkem použití osy ancestor-or-self jsou všichni předci uzlu u včetně uzlu u. Výsledkem použití osy child jsou všechny děti uzlu u. Výsledkem použití osy descendant jsou všichni potomci uzlu u. Výsledkem použití osy descendant-or-self jsou všichni potomci uzlu u včetně uzlu u.
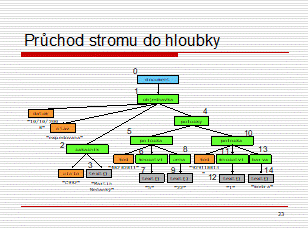
Dále je znázorněno očíslování uzlu stromového modelu XML dokumentu pomocí algoritmu DFS (průchod stromem do hloubky). Čísla uzlů jsou uvedena nahoře vlevo u každého z nich. Toto očíslování uzlů se využívá u následujících několika os.
Výsledkem použití osy preceding-sibling jsou všichni sourozenci uzlu u, kteří mají nižší číslo přidělené průchodem stromu do hloubky. Sourozenci, kteří se nacházejí v dokumentu před uzlem u. Výsledkem použití osy preceding jsou všechny uzly, které mají nižší číslo přidělené průchodem stromu do hloubky než jaké je přiděleno uzlu u. Uzly, které se nacházejí v dokumentu před uzlem u.
Výsledkem použití osy following-sibling jsou všichni sourozenci uzlu u, kteří mají vyšší číslo přidělené průchodem stromu do hloubky. Sourozenci, kteří se nacházejí v dokumentu za uzlem u. Výsledkem použití osy following jsou všechny uzly, které mají vyšší číslo přidělené průchodem stromu do hloubky než jaké je přiděleno uzlu u. Uzly, které se nacházejí v dokumentu za uzlem u.
Výsledkem použití osy attribute jsou všechny atributy uzlu u. Tato osa jako jediná vybírá do výsledku atributy, všechny ostatní osy atributy ignorují.

1.3 Test uzlu
Po výběru množiny uzlů za použití příslušné osy přichází na řadu test těchto vybraných uzlů. Testuje se typ uzlu, případně i jeho název. Zatím jsme se seznámili pouze s testem na přesný název uzlu (kapitola 1.1)
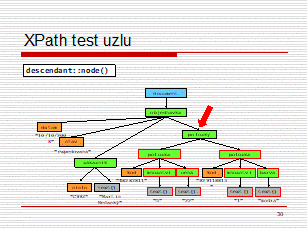
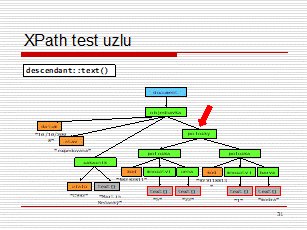
Testem node() úspěšně projdou všechny uzly vybrané osou. Na slajdu vidíme vybrání všech potomků (osa descendent) uzlu položky. Testem text() úspěšně projdou všechny textové uzly vybrané osou. Na slajdu vidíme vybrání všech textových uzlů, které jsou potomky položky.
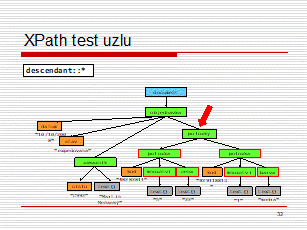
Testem * projdou všechny uzly vybrané osou, které mají jméno. Jméno mají všechny elementy i atributy, ale neexistuje osa, které by vybírala z obou skupin zároveň. Nepojmenované jsou uzly s textovým obsahem, ty vybrány nebudou nikdy. Na slajdu vidíme vybrání všech pojmenovaných elementových potomků uzlu položky.
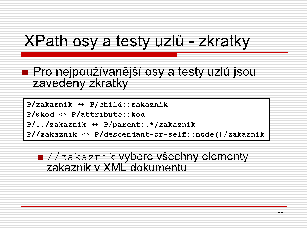
Na slajdu vidíme zkrácené zápisy pro některé kombinace os a testů uzlů. Písmeno P značí předchozí část cesty. Na prvním řádku je název osy vynechán, použije se defaultní osa child (s tímto zápisem jsme se již seznámili) na druhém řádku symbolem @ nahrazujeme osu attribute. Na třetím řádku pomocí dvou teček (..) nahrazujeme plný zápis pro vybrání rodičovského uzlu použití osy parent. Jedná se o analogii pro přístup k rodičovskému adresáři v souborovém systému. Na čtvrtém řádku vidíme prázdný krok //, což je zkrácený zápis pro přeskočení libovolného množství potomků. Často se používá zápis //název pro vybrání všech uzlů daného jména název v celém dokumentu bez ohledu na jejich umístění
1.4 Podmínka
Po výběru množiny uzlů za použití příslušné osy a jejich otestování podle typu uzlu může nepovinně následovat podmínka, která z množiny uzlů odstraní ty uzly, která ji nesplňují. Podmínek smí být použito více za sebou. Podmínka se nachází v hranatých závorkách [ ] a může být i složená za použití logických spojek and, or a not. V případě spojky not je nutné negovanou podmínku navíc uzávorkovat kulatými závorkami.
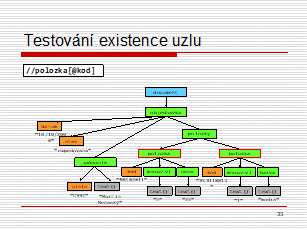
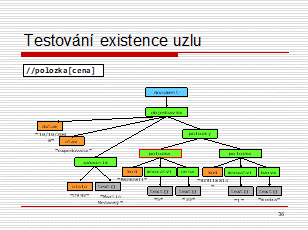
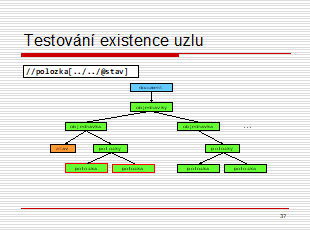
Podmínkou může být relativní (vzhledem ke zpracovávanému uzlu) XPath cesta. Tento typ podmínky je vyhodnocen jako splněný, pokud množina uzlů daná relativní cestou v podmínce je neprázdná.
Na slajdu vidíme příklad na tento typ podmínky (existence uzlu daného relativní cestou). Dotaz na slajdu vybere ty uzly položka, které obsahují atribut kód. Do výsledné množiny uzlů jsou zařazeny oba uzly položka, které se v dokumentu nacházejí. Na slajdu je podobný dotaz. Vybíráme uzly položka, které obsahují atribut cena. Tuto podmínku splňuje pouze jeden uzel (levý).
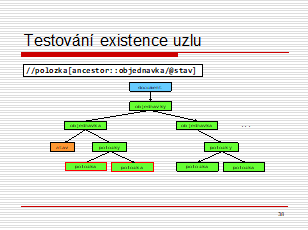
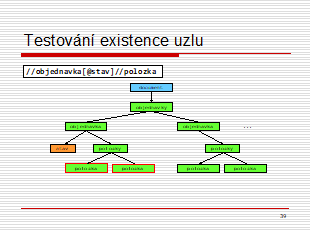
Na slajdu vidíme opět použití relativní cesty v podmínce dotazu. Testujeme zda dědeček uzlu položka obsahuje atribut stav. Na slajdu testujeme zda některý ze předků uzlu položka obsahuje atribut stav. V našem stromovém modelu XML dokumentu je výsledek dotazu shodný s předchozím dotazem, v obecném XML dokumentu se mohou lišit. Na slajdu je opět výsledek dotazu shodný s předchozími dvěma dotazy, ale v obecném XML dokumentu se výsledek může lišit.
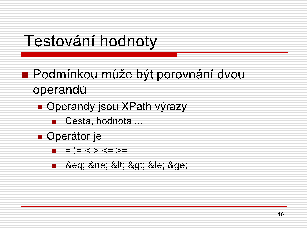
V podmínce můžeme také porovnávat relativní XPath cestu (k atributu nebo elementu) s hodnotou pomocí operátorů =, !=, <, >, <=, >=. Pokud je operandem element, jeho hodnotou pro porovnávání je jeho textový obsah. V podmínce lze také použít operátory &eq; ≠ < > ≤ ≥ pro porovnání dvou hodnot.(nesmí se jednat o uzly). Pokud by jedním z jejich operandů byl uzel, převede se na textovou hodnotu. Tyto operátory bývají častěji použity chybně, než správně a úmyslně.
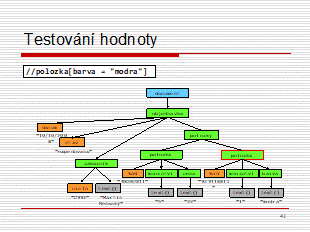
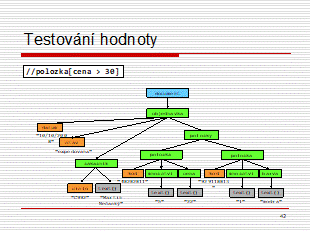
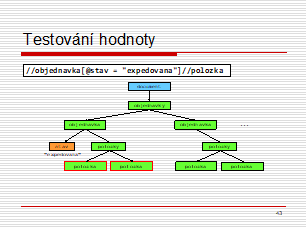
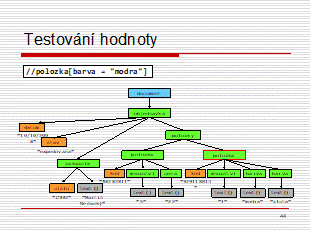
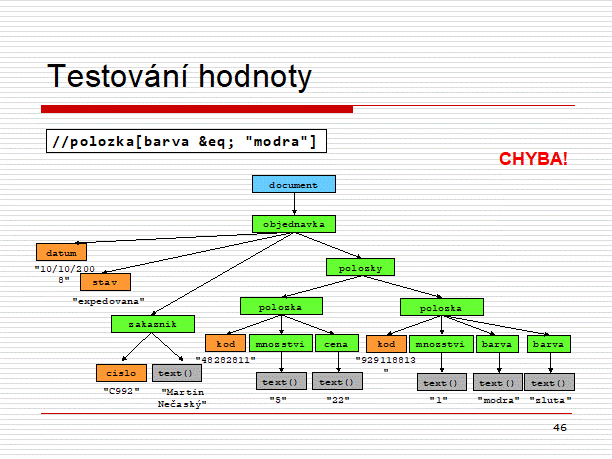
Na slajdu vidíme dotaz vyhledávající uzly položka, které obsahují element barva s hodnotou textového obsahu modrá. Na slajdu vidíme dotaz vyhledávající uzly položka, které obsahují element cena s hodnotou textového obsahu (který se automaticky konvertuje na číslo) větším než 30. Výsledek dotazu je prázdný. Na slajdu vidíme složitější dotaz. Hledáme uzly položka, které mají předka objednávka s hodnotou atributu stav expedován.
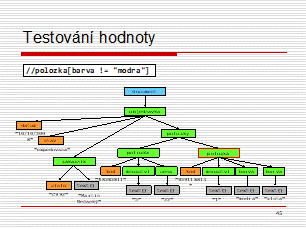
Na slajdu opět vidíme dotaz vyhledávající uzly položka, které obsahují element barva s hodnotou textového obsahu modrá. Na slajdu vidíme dotaz, který vrátí ten samý výsledek co předchozí dotaz, přestože jsme v podmínce změnili operátor = na !=. Protože uzel položka obsahuje dva elementy barva, je podmínka splněna pro druhý z elementů barva, který má hodnotu žlutá. Pokud chceme najít uzel položka, který nemá žádný z elementů barva s hodnotou modrá, musíme použít zápis [not (barva = "modrá")]. Na slajdu vidíme syntakticky špatný zápis kdy místo operátoru = použijeme eq;.
1.5 Vestavěné funkce
V právě zpracovávaném kroku XPath cesty pracujeme s několika uzly. Tyto uzly mají své pořadí dané jejích umístěním v XML dokumentu a směrem použité osy. Voláním funkce position() toto pořadí zjistíme. Voláním funkce last() zjistíme počet uzlů se kterými v daném kroku cesty pracujeme.
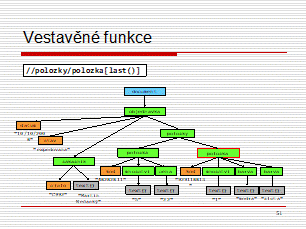
Na slajdu hledáme uzel položka, který je prvním potomek uzlu položky. Na slajdu hledáme uzel položka, který je posledním potomek uzlu položky. V obou případech jsme použili funkci position() a její hodnotu jsme porovnali s požadovanou pozicí uzlu. Tento typ podmínky má i svůj zkrácený zápis, ve kterém je celá rovnost nahrazena požadovanou pozicí uzlu. Na slajdech jsou tyto zkrácené zápisy předvedeny.
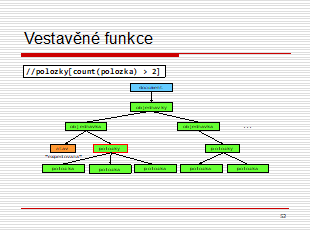
Funkce count vrací počet uzlů, které jsou výsledkem XPath výrazu uvedeného jako její parametr. Na slajdu v dotazu hledáme uzly položky, které mají nejméně 3 uzly položka.
Na slajdu vidíme seznam dalších vestavěných funkcí, jedná se zejména o funkce řetězcové a matematické.
2 XPath v SQL Serveru
Práce s XPath v každém databázovém systému bývá řešena rozdílnými způsoby. My si v této kapitole popíšeme situaci v SQL Serveru 2005.
V SQL dotazu v klauzuli SELECT můžeme u sloupců datového typu XML použit následující funkce query, exist a value, které vykonají XPath (obecně dokonce XQuery) dotaz na hodnotách daného sloupce (datového typu XML).
Funkce query vrací část XML dokumentu, která je výsledkem XPath dotazu aplikovaného na XML dokument, který je hodnotou daného sloupce, na kterém je funkce zavolána. Funkce exist vrací hodnotu 1 pokud je výsledek dotazu tvořen alespoň jedním uzlem. Pokud je výsledkem dotazu prázdná množina, výsledná hodnota je 0. Funkce value má dva parametry, prvním z nich je dotaz a druhým datový typ. Výsledek dotazu (hodnota uzlu) se převede na požadovaný datový typ.
Pokud se tabulka jmenuje XMLTab a sloupec datového typu XML data se jmenuje xml, poté základní dotaz vypadá následovně. SELECT xml.query('text dotazu') FROM XMLTab. Dotaz může být i složitější, může obsahovat i všechny další klauzule.
Funkce modify umožňuje mazat nebo vkládat části XML dokumentu v rámci příkazu UPDATE. Jejím parametrem je opět XPath (obecně dokonce XQuery dotaz). Při mazání je doplněn o slovo delete. Při vkládání začínáme slovem insert, následuje kus XML dokumentu, který má být vložen a pokračuje slovem into následovaným samotným dotazem udávající místo vložení. Místo vložení musí být jednoznačně určený uzel, například pomocí plné cesty od kořene až k danému uzlu a uzly na této cestě mají daná pořadová čísla, jako v příkladě dole.
V následujícím příkladě prvním příkazem do XML dokumentu vložíme element xxx. a druhým příkazem ho vymažeme.
UPDATE XMLtab
SET xml.modify('insert <xxx>test</xxx> into /PLAY[1]/TITLE[1]')
WHERE id=1*/
UPDATE XMLtab
SET xml.modify('delete /xxx')
WHERE id=1