Neprohledávají se striktně strukturovaná data, kde má každý sloupec každé tabulky předem daný význam. Prohledávají se volně psané texty, kde může být stejná událost popsaná více autory rozdílně.
Při fulltextovém vyhledávání hledáme v množině dokumentů takové dokumenty, ve kterých se vyskytuje námi požadované slovo nebo slova. Můžeme hledat i v rámci jednoho dokumentu pozici nebo pozice výskytů daného slova či slov. Nemůžeme využít vnitřní struktury prohledávaného dokumentu.
Fulltextového vyhledávání v rámci jednoho dokumentu využívají například textové editory. Fulltextově prohledávat větší množství souborů nám umožňují i operační systémy. Nejčastěji se s fulltextovým vyhledáváním setkáváme v prostředí internetu, při vyhledávání webové stránky pomocí webového vyhledávače.
Databázové systémy (včetně SQL Serveru) mají obvykle své rozšíření pro práci s textovými daty. Sloupec tabulky může být datového typu, který umožní uchovat celý textový dokument. V takto uložených textových dokumentech lze fulltextově vyhledávat. Přestože v oblasti fulltextového vyhledávání v databázových systémech existuje standard SQL/MM 2 (SQL Multimedia and Application Packages Part 2: Full-Text), nebývá dodržován. Fulltextové vyhledávání v jednotlivých databázových systémech používá rozdílnou syntax a skript napsaný pro jeden databázový systém není přenositelný na jiný databázový systém.
Reálně rozdílné přístupy a možnosti:
· Neexistuje objektivně nejlepší řešení
· Výsledky navíc podléhají subjektivním názorům tazatelů
Text je posloupností slov v přirozeném jazyce. Každé slovo zastupuje pro autora nějakou představu, kterou v něm slovo vyvolává – význam slova. Tyto představy reprezentují reálné předměty.
1. Synonymie slov - více slov může mít pro autora stejný význam (krychle = kostka)
2. Homonymie slov
2.1. Jedno slovo může mít pro autora několik významů (taška: střešní, nákupní)
2.2.
Jedno slovo může používat stejný tvar pro různé
pády a další gramatické jevy (gramatická homonymie)
př. kontroly: 1. p. m.č., 2. p. j.č.
není zřejmé, zda se jedná o jednu, nebo více kontrol
2.3.
Jeden tvar slova může mít různý význam
př. plesy: podst. jm. ples, podst. jm. pleso
3.
Hierarchie významů
Zvíře – Savec – Šelma – Medvěd
Tiskovina – Časopis
4. Asociace
kalkulátor ~ počítač ~ procesor
· Dva DIS(dokumentografické informační systémy) mohou vrátit na shodný dotaz různé odpovědi, které se nemusí překrývat ani v jediném vráceném dokumentu.Jak porovnat kvalitu odpovědí navzájem ?
· Dva tazatelé mohou mít při položení shodného dotazu různý názor na relevanci vrácených dokumentů.Jak vyhovět subjektivnímu názoru tazatelů?
Nvr - počet vrácených relevantních dokumentů
Nv - počet všech vrácených dokumentů
Nr - počet relevantních dokumentů
Přesnost (Precision)
P = Nvr /
Nv
Pravděpodobnost, že dokument zařazený v odpovědi je skutečně relevantní
Úplnost (Recall)
R
= Nvr / Nr
Pravděpodobnost, že skutečně relevantní dokument je zařazený v odpovědi
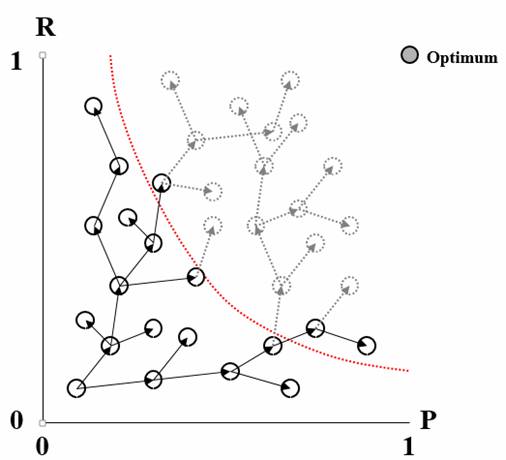
V praxi jsou koeficienty přesnosti a úplnosti na sobě nepřímo závislé, jejich součin je konstanta výrazně menší než jedna(P*R @ konst. < 1). Pokud se snažíme zvýšit přesnost, snížíme počet získaných relevantních dokumentů. Pokud se snažíme zvýšit úplnost, získáme větší podíl nerelevantních dokumentů.
Při formulaci dotazů je potřebné uhádnout, které termy (slova) byly v dokumentu autorem použity pro vyjádření dané myšlenky. Problém může způsobit použití synonym, které tazatele při formulaci dotazu nemusí ani napadnout, překrývání významů slov, či opisy jedné situace jinými slovy. Kritérium predikce se zabývá zajištěním shody při výběru termínu použitých v dotazu a v hledaném dokumentu.
Částečným řešením je zařazení tezauru(řízený slovník deskriptorů), který obsahuje hierarchie slov(vztahy nadřazenosti a podřazenosti) a jejích významů, synonyma slov a asociace mezi slovy. Tazatel může tezaurus využít při formulaci dotazů.
Jiná definice tezauru : „Řízený a měnitelný slovník deskriptorového a selekčního jazyka uspořádaný tak, že explicitně zachycuje apriorní vztahy mezi lexikálními jednotkami.“
Při ladění dotazů mají uživatelé tendenci se chovat konzervativně. V dotazu zůstávají ty části, které uživatele napadly na začátku a mění se jen ty části, které uživatele napadly později a podle uživatele pouze zpřesňují dotaz, ale v případě nekvalitního výsledku nemají šanci ho vylepšit.
Je vhodné uživateli pomoci s odstraňováním části dotazu, které vedou k nerelevantním dokumentům a naopak mu navrhnout vylepšení dotazu, které k relevantním dokumentům vedou. Relevanci najitých dokumentů musí uživatel sám posuzovat.
Kritérium maxima říká, že uživatel je schopen a ochoten si prohlédnout 20-50 vrácených dokumentů. Větší počet vrácených dokumentů bude pravděpodobně nevyužit. Je třeba dokumenty řadit sestupně podle míry předpokládané relevance a v tomto pořadí je předkládat uživateli.
V důsledku kritéria maxima se uživatel obvykle snaží zvýšit přesnost, najít malé množství dokumentů, mezi kterými se téměř nevyskytují nerelevantní dokumenty. V některých oblastech je potřeba kromě přesnosti i úplnost (například právo).
Pro fulltextové vyhledávání se používají dva modely: boolský a vektorový. V jednodušším boolském modelu jsou dotazy tvořeny ve formě boolských formulí. Formule se skládají z hledaných slov, která jsou spojena logickými spojkami (konjunkce, disjunkce, negace). Nejčastěji uživatelé hledají konjunkci zadaných slov.
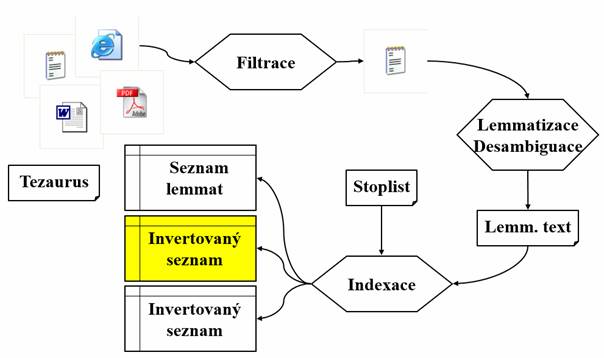
První fáze je filtrace, při které se z dokumentu získá čistý text odstraněním formátovacích značek. Následuje Desambiguace, při které se podle kontextu určí význam jednotlivých slov. Následuje lematizace, při které se určí základní tvar slova.
V další fázi se vytvoří index, který bude použitý při vyhledání konkrétních dotazů. Tomuto indexu se říká invertovaný seznam a obsahuje ke každému slovu (přesněji lematu) seznam dokumentů, ve kterých se dané slovo nachází. Můžou zde být i doplňkové informace o přesných pozicích výskytu slova v dokumentu.
Slouží k sestavování „fuzzy“, tedy „neostrých“ podmínek pro porovnávání textových řetězců. Základní syntaxe předpokládá zadání sloupce nebo seznamu sloupců, případně zástupného znaku * a podmínky.
Funkce může vyhledávat :
· Slovo nebo slovní spojení(frázi)
· Prefix slova nebo fráze (prefix*)
· Slovo blízko jiného slova (NEAR)
· Slovo vzniklé skloňováním,nebo časováním základního tvaru - FORMSOF(INFLECTIONAL,slovo)
· Slovo, které je synonymem jiného slova – FORMSOF(THESAURUS,slovo)
Syntaktická definice příkazu :
CONTAINS (
{
column_name | ( column_list )
| *
| PROPERTY ( { column_name }, 'property_name' )
}
, '<contains_search_condition>'
[ , LANGUAGE language_term ]
)
Syntaktická definice podmínky :
<contains_search_condition> ::=
{
<simple_term>
| <prefix_term>
| <generation_term>
| <generic_proximity_term>
| <custom_proximity_term>
| <weighted_term>
}
|
{ ( <contains_search_condition> )
[ { <AND> | <AND NOT> | <OR> } ]
<contains_search_condition> [ ...n ]
}
<simple_term> ::=
{ word | "phrase" }
<prefix term> ::=
{ "word*" | "phrase*" }
<generation_term> ::=
FORMSOF ( { INFLECTIONAL | THESAURUS } , <simple_term> [ ,...n ] )
<generic_proximity_term> ::=
{ <simple_term> | <prefix_term> } { { { NEAR | ~ }
{ <simple_term> | <prefix_term> } } [ ...n ] }
<custom_proximity_term> ::=
NEAR (
{
{ <simple_term> | <prefix_term> } [ ,…n ]
|
( { <simple_term> | <prefix_term> } [ ,…n ] )
[, <maximum_distance> [, <match_order> ] ]
}
)
<maximum_distance> ::= { integer | MAX }
<match_order> ::= { TRUE | FALSE }
<weighted_term> ::=
ISABOUT
( {
{
<simple_term>
| <prefix_term>
| <generation_term>
| <proximity_term>
}
[ WEIGHT ( weight_value ) ]
} [ ,...n ]
)
<AND> ::=
{ AND | & }
<AND NOT> ::=
{ AND NOT | &! }
<OR> ::=
{ OR | | }
Používá se pro vytváření fulltextových dotazů, jejichž výsledky mají obsahovat číselné vyjádření relevance textu s dotazem. Parametry funkce jsou tabulka, textový sloupec této tabulky a dotaz. Nepovinně může následovat jazyk textu a omezení na daný počet nejvíce relevantních odpovědí. Funkce vrací tabulku hodnot shody textového sloupce původní tabulky s dotazem. Tabulka vrácená výsledkem dotazu obsahuje dva sloupce KEY a RANK. Sloupec KEY obsahuje identifikátor řádku (dle unikátního klíče použitého při tvorbě fulltextového indexu) Sloupec RANK je ohodnocení relevance textového sloupce s dotazem (čím vyšší hodnota, tím relevantnější dokument).
Syntaktická definice příkazu :
CONTAINSTABLE ( table , { column_name | ( column_list ) | * } , ' <contains_search_condition> '
[ , LANGUAGE language_term]
[ , top_n_by_rank ]
)
Syntaktická definice podmínky :
<contains_search_condition> ::=
{ <simple_term>
| <prefix_term>
| <generation_term>
| <generic_proximity_term>
| <custom_proximity_term>
| <weighted_term>
}
| { ( <contains_search_condition> )
{ { AND | & } | { AND NOT | &! } | { OR | | } }
<contains_search_condition> [ ...n ]
}
Syntakticky chová spíše jako funkce. Své operandy má uzavřeny v kulatých závorkách a oddělené čárkou. Prvním operandem je buďto INFLECTIONAL pro hledání všech slovních tvarů nebo THESAURUS pro hledání slov s podobným významem. Druhým parametrem je slovo uzavřené v uvozovkách, pro které se první parametr vyhodnocuje.
Syntax:
FORMSOF ( { INFLECTIONAL | THESAURUS } , <simple_term> [ ,...n ] )
Příklad:
Články, se kterými mají něco společného fyzici, neboli ve kterých jsou tvary slova - fyzik.
select * from Article where contains(MainContent,'FORMSOF(INFLECTIONAL,"fyzik")');
Má své operandy v závorce, takže na první pohled vypadá jako funkce. Jednotlivé operandy jsou slova (bez použití uvozovek nebo apostrofů) následované klíčovým slovem WEIGHT a v závorce uzavřenou váhou slova v dotazu. Váha slova může nabývat hodnot z intervalu [0,1]. Čím je hodnota větší, tím je větší důležitost daného slova v dotazu. Operandů může být libovolné množství, jsou vzájemně oddělené čárkami. Operátor ISABOUT je vhodný pro dotazy s využitím CONTAINSTABLE.
Syntax:
ISABOUT
( {
{
<simple_term>
| <prefix_term>
| <generation_term>
| <proximity_term>
}
[ WEIGHT ( weight_value ) ]
} [ ,...n ]
)
Příklad :
Top 10ProductIDs(PK) with aRANKField in theProductDetailsTable
SELECT * FROM CONTAINSTABLE( ProductDetails, *, ISABOUT("Nikon" WEIGHT (1.0), "Cameras" Weight(0.9)), 10 )