indexy, optimalizace dotazu
Index, B stromový, bitmapový, selektivita sloupce. B strom, redundantní B strom, redundantní B+ strom. Jednosloupcový a vícesloupcový index, klastrovaný a neklastrovaný index. Optimalizace dotazu, plán provedení dotazu.
1 Indexy
Index je pomocná datová struktura nad databázovou tabulkou, která slouží ke zrychlení vyhledávání v datech v této tabulce obsažených. Vyhledávání v datech probíhá nejen při vyhodnocování podmínky v klauzuli WHERE, ale například také při spojování tabulek, kde se vyhodnocuje spojovací podmínka, obvykle rovnost primárního a cizího klíče. Vyhledávání v datech pro vyhodnocování podmínek (v klauzuli WHERE a při spojování tabulek) obvykle zabírá největší část z doby běhu dotazu. Navíc je při něm často vyžadováno čtení dat z disku. Diskové operace jsou řádově pomalejší (čtení 1 bloku dat trvá cca 10-20 ms) než operace prováděné v paměti. Díky použití indexu čteme z disku menší množství dat. Použití indexu snižuje počty paměťových a diskových operací a tedy i celkovou dobu běhu dotazu.
Index může být vytvořen pro konkrétní sloupec nebo sloupce jedné tabulky (jednosloupcový) nebo pro více sloupců jedné tabulky(vícesloupcový). Pro jednoduchost začneme s indexy jednosloupcovými. Další předpoklad je, že každá hodnota daného sloupce se v tabulce nachází nejvýše v několika málo řádcích. Princip indexu spočívá v tom, že ke každé hodnotě daného sloupce dané tabulky přidáme nějakou dodatečnou informaci o tom, kde přesně (na disku v prostoru vyhrazeném pro naší tabulku) máme hledat řádek nebo řádky s danou hodnotou sloupce. Informace, které používá index pro vyhledávání, jsou uloženy ve stromové struktuře, která nám zaručuje logaritmický čas přístupu (vzhledem k počtu řádek tabulky). Bez použití indexu, bychom museli prohledat všechny řádky tabulky (lineární čas).
Použití indexu je nejvýhodnější pro dotazy, ve kterých probíhá vyhodnocení podmínky na rovnost hodnoty sloupce s konstantou (například: které zboží stojí 100 korun) nebo na příslušnost hodnoty sloupce do intervalu (například: které zboží stojí mezi 20 a 50 korunami).
Nevýhodou indexu je, že po každé aktualizaci hodnoty v daném sloupci (například: vložení, smazaní řádky tabulky), musíme aktualizovat i tento index. V našem případě stromového indexu se bude jednat o logaritmický čas. Další nevýhodou je dodatečný diskový prostor, který index zabírá, ten je lineární vzhledem k počtu uložených záznamů.
Pokud je podíl záznamu vyhovujících podmínce příliš vysoký (například: hledáme osoby se státním občanstvím ČR mezi zaměstnanci české firmy), indexy nám nepomohou, naopak ještě prodlouží dobu vyhodnocení dotazu. V indexech se běžně neukládá hodnota NULL, takže při jejím vyhledávání v dotazu (například: hledáme zaměstnance, kteří nemají vyplněný osobní e-mail) nám index nepomůže.
Syntaxe tvorby indexů se v mírných detailech liší na různých databázových systémech (dlouho dobu nebyla standardizována normou SQL). Rovněž (ne)využití konkrétního indexu v konkrétním dotazu je závislé na konkrétním databázovém systému. Například SQL Server obecně využívá indexy lépe než mySQL.
Problematika typů indexů a jejich implementace je velmi rozsáhlá (polovina knihy [2], je vhodné ji aspoň prolistovat a prohlédnout si obrázky), my si ji pouze stručně nastíníme. V našem učebním textu je použitá terminologie zredukována na minimum a je přizpůsobena terminologii používanou v databázových systémech. Popisy datových struktur jsou pouze ilustrační a zjednodušené. Nejběžněji používané typy indexů jsou B stromový index (kapitola 1.1) a bitmapový index (kapitola 1.3).
1.1 B stromový index
B stromový index se nejlépe hodí pro sloupce, ve kterých se jednotlivé hodnoty daného sloupce nacházejí v dané tabulce nejvýše v několika málo řádcích. Takové sloupce nazýváme sloupci s vysokou selektivitou. V následujícím popisu je použit pojem prvek, pod kterým si můžeme představit řádek tabulky.
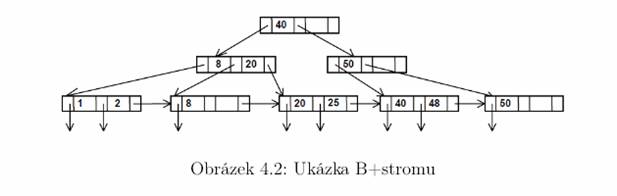
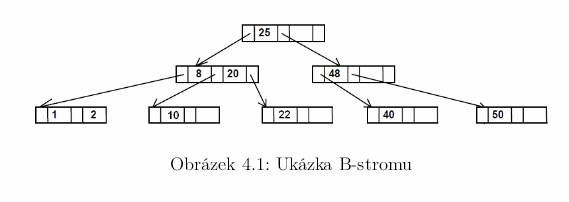
B stromový index bývá obvykle implementován datovou strukturou redundantního B+ stromu. Vysvětlíme si tuto strukturu neformálně. B strom je n-arní strom, kde n je maximální stupeň uzlu a bývá v praxi v řádu stovek. Vzdálenost všech listů od kořene stejná. V uzlu B stromu je uloženo ën/2û až n-1 prvků. Výjimku tvoří kořen, ve kterém může být 1 až n-1 prvků. Prvky jsou v uzlu uspořádány vzestupně dle hodnoty klíče. Ke každému prvku uzlu přísluší dva synové, levý a pravý. Sousední prvky (levější prvek a pravější prvek) v uzlu mají společného syna. Pravý syn levějšího prvku je zároveň levým synem pravějšího prvku. Každý uzel má celkově o jednoho syna více, než je počet prvků (otců) v daném uzlu uložených. Všechny hodnoty klíčů v podstromu levého syna jsou menší než hodnota klíče otce. Všechny hodnoty klíčů v podstromu pravého syna jsou větší než hodnota klíče otce.
Zatím jsme si představili (neredundantní) B strom. V redundantním B stromu se vyskytují data pouze v listech. V nelistových uzlech se vyskytují pouze hodnoty klíče bez dat. Redundance spočívá v tom, že v nelistových uzlech se mohou opakovat shodné hodnoty klíče. V listech, kde se vyskytuje klíč i s daty, k opakování prvků nedochází. Paměť zabraná klíčem, bývá řádově menší než paměť zabraná celým prvkem, proto je možné v redundantním B stromu mít větší stupeň nelistovém uzlu a tím snížit hloubku stromu.
V redundantním B stromu lze navíc propojit sousední listové uzly ukazateli, vznikne tak redundantní B+ strom. Tato úprava usnadní dotazy na příslušnost hodnoty klíče do daného intervalu. Protože listy jsou setříděné vzestupně, lze vyhledat přes indexovou strukturou pouze levou mez intervalu a k pravé mezi dojít postupným průchodem prvků v listech.
Příklad: Mějme tabulku s 100 miliony řádky a redundantní B+ strom se stupněm nelistového uzlu 800. K najití řádku s danou hodnotou sloupce (klíče) nám budou stačit 4 přístupy na disk: 3 na načtení indexové struktury (protože 108/8003 <1) a 1 na načtení najitého řádku.
U B stromových indexů rozlišujeme dva typy: klastrovaný index a neklastrovaný index. Klastrovaný index se obvykle používá na primární klíč tabulky a je implementován redundantním B+ stromem. Klastrovaný index může být nad danou tabulkou pouze jeden. Neklastrovaný index bývá implementován redundantním B+ stromem, který nemá v listech samotná data, ale pouze odkazy na ně. Neklastrovaných indexů může být v tabulce více.
Praktické rozdíly mezi kastrovaným a neklastrovaným indexem jsou zejména tyto dva. Neklastrovaný index potřebuje pro přístup k datům obvykle o jeden přístup na disk více než klastrovaný index. V případě intervalového dotazu jsou prvky najité pomocí klastrovaného indexu uložena na disku za sebou, takže jejich čtení zabírá relativně malý čas. V případě použití neklastrovaného indexu nejsou nalezené prvky na disku za sebou a musíme pro přečtení každého prvku provádět operaci seek (nastavení hlavičky disku, cca 5 ms).
1.2 Vícesloupcový B stromový index
Praktickým příkladem vícesloupcového indexu může být kombinace sloupců příjmení, jméno a adresa. Aby šel vícesloupcový index (s m sloupci) použít pro vyhledávání, musí být zadány hodnoty prvního až n-tého (n £ m) sloupce indexu. Tento index lze využít pro dotazy na hodnotu příjmení nebo kombinaci hodnot příjmení a jméno, nebo kombinaci hodnot příjmení, jméno a adresa. Index naopak nelze použít pro dotazy na hodnotu jména nebo hodnotu adresy nebo kombinaci hodnot jméno a adresa.
Nyní se pokusíme tento vícesloupcový index implementovat pomocí B stromu. Pro první sloupec (příjmení) vytvoříme redundantní B strom, který bude mít v listech místo konkrétních prvků pouze odkazy na vrcholy redundantních B stromů pro druhý sloupec (jméno). Redundantní B stromy pro druhý sloupec jsou menší, obsahují pouze prvky se shodnou hodnotou prvního sloupce. V listech redundantních B stromů pro druhý sloupec budou odkazy na vrcholy redundantních B+ stromů pro třetí sloupec (adresa). Tyto redundantní B+ stromy pro třetí sloupec budou velmi malé, každý z nich bude obsahovat prvky se shodnou hodnotou prvního a druhého sloupce. Teprve zde v listech budou záznamy.
Vyhledávání v této struktuře je komplikovanější. Pokud je zadána úplná trojice hodnot, příjmení, jméno a adresa, projdeme postupně všechny tři redundantní B stromy a v posledním z nich bude v listu uložený výsledný prvek. Pokud je zadána pouze dvojice hodnot příjmení a jméno, výsledkem dotazu jsou všechny prvky, obsažené v listech třetího podstromu (pro adresy). Bývají zde speciální ukazatele na první a poslední prvek, vyhovující dané dvojici hodnot příjmení a jméno, který umožní přeskočit průchod redundantním B+ stromem pro adresu. Při zadání pouze příjmení se analogicky přeskočí indexová struktura pro jméno a adresu.
1.3 Bitmapový index
Bitmapový index se hodí pro sloupce ve kterých se stále opakuje pouze několik málo unikátních hodnot (například sloupec pohlaví, barva auta, den v týdnu). Takové sloupce nazýváme sloupci s nízkou selektivitou. Použití B stromového indexu by vedlo k prodloužení doby dotazu než k jejímu zkrácení.
Zatímco B stromový index se vyráběl pro daný sloupec tabulky, bitmapový index se vyrábí pro danou hodnotu daného sloupce tabulky. Pokud se v daném sloupci tabulky nachází například pět unikátních hodnot, můžeme pro tento sloupec vytvořit pět bitmapových indexů.
Z implementačního hlediska je bitmapový index velmi jednoduchý. Bitmapový index tvoří pole bitů, každý bit odpovídá jednomu řádku tabulky. Pokud řádek tabulky má požadovanou hodnotu sloupce, je v bitovém indexu na dané pozici bit 1. Pokud má jinou hodnotou, je na dané pozici bit 0. Při hledání řádků s danou hodnotou sloupce (s pomoci bitmapového indexu) stačí z disku načíst pouze ty záznamy, které mají na odpovídající pozici v bitové mapě hodnotu 1.
Největší výhodou bitmapových indexů je možnost použití více bitmapových indexu v rámci vyhledávání záznamů v jedné tabulce. U B stromových indexů jsme mohli použít vždy jen jeden z nich. U bitmapového indexu lze pomocí bitové negace, konjunkce a disjunkce velmi snadno určit, které záznamy splňují požadovanou kombinaci logických podmínek. Výsledkem je bitová mapa, ve které řádku tabulky odpovídá hodnota 1, právě tehdy když daný řádek splňuje požadovanou kombinaci podmínek.
1.4 Použití indexů
Již víme na jakých principech indexy fungují, zbývá zodpovědět otázku, kdy je použít. Databázové systémy (včetně SQL serveru) obvykle automaticky vytvářejí index pro primární klíč tabulky a také pro sekundární klíče (definované integritním omezením UNIQUE).
Indexy se dají využít při filtrování záznamů v klauzuli WHERE, ale také při spojování tabulek, které obvykle probíhá podle rovností primárního klíče jedné tabulky a cizího klíče tabulky druhé. Index pro primární klíč je vytvořen automaticky, ale pro cizí klíč není. Aby nedocházelo ke čtení všech řádek z druhé tabulky, měli bychom definovat index pro každý cizí klíč.
Při návrhu indexů je nutné se zamyslet, které dotazy budou často kladené. Velmi často se jedná o dotazy, pomocí kterých jsou vytvořeny pohledy. Má smysl vytvářet indexy právě pro tyto velmi často kladené dotazy. Indexy vytváříme pro sloupce, jejichž hodnoty v klauzuli WHERE testujeme na rovnost s konstantou nebo příslušnost do intervalu.
Pokud vytvoříme index na sloupec, který není cizím klíčem a jehož hodnoty v klauzuli WHERE budeme testovat velmi zřídka, přínos bude záporný. Existence každého indexu prodlužuje dobu pro vkládání, mazání nebo aktualizaci řádky tabulky. Protože musíme po každé této operaci modifikovat i tento index.
Indexy se vytvářejí pomocí příkazu CREATE INDEX. V tomto příkazu musíme specifikovat na jaké tabulce se index vytváří a pro jaký sloupec nebo sloupce je vytvořen. Každý index by měl být vhodně pojmenován, například kombinací jména tabulky a sloupce(ů) pro které je vytvořen.
MSSQL Server bitmapové indexy neumožňuje vytvořit.
Pokud chceme zjistit informace o existujících indexech v dané databázi, v SQL Serveru je nalezneme v pohledech sys.indexes a sys.index_columns. Obsah pohledů lze zobrazit příkazem SELECT.
2 Optimalizace dotazu
Každý dotaz lze zapsat různými zápisy. Pokud chceme v databázi Northwind zjistit jména zaměstnanců, můžeme provést jednoduchý dotaz na tabulce Zaměstnanci, obsahující pouze klauzule SELECT a FROM. Můžeme také zvolit složitější postup a tabulku Zaměstnanci spojit s další tabulkou, například Objednávky, a jména zaměstnanců zjišťovat až z těchto spojených tabulek. Tento příklad je na první pohled uměle vytvořený, ale existuje mnoho přirozených příkladů. Složitější praktické dotazy obvykle nabízejí na výběr mezi připojením další tabulky nebo použitím vnořeného dotazu. Rozdílné zápisy dotazů vzniknou i prohozením pořadí podmínek v klauzuli WHERE nebo rozdílným pořadím spojování tabulek.
Každý zápis dotazu se může vyhodnotit rozdílným způsobem. Způsob vyhodnocení daného zápisu dotazu záleží na konkrétním databázovém systému. Vyhodnocení dvou zápisů jednoho dotazu vrátí sice stejný výsledek (shodné řádky), ale může mít rozdílný čas a to i řádově. Optimalizací dotazu je hledání takového ze zápisů dotazu, který bude mít nejnižší dobu zpracování.
Optimalizovat má smysl zejména dotazy, které se používají velmi často. Pro každý zápis dotazu se mohou využít jiné indexy. Pro testování, který zápis dotazu bude nejvýhodnější je vhodné vyrobit indexy pro všechny testované zápisy. Po vybrání nejvhodnějšího zápisu, je dobré indexy, které tento zápis nepoužívá (a nejsou používány jinými dotazy) zrušit příkazem DROP INDEX.
Databázové systémy používají obvykle jednu ze dvou forem optimalizace: rule-based a cost-based. Rule-based optimalizace je historicky starší a odvozuje plán provedení dotazu ze syntaktického zápisu dotazu a existence indexů, tento typ optimalizace lze nalézt například v databázovém systému Oracle. Pomocí různých syntaktických doplňků (hintů) k zápisu dotazu jde určovat například pořadí spojování tabulek, výběr použitých indexů atd.
Novějším typem je cost-based optimalizace, která využívá statistik o počtu řádek tabulek a jejich délce, histogramy rozložení hodnot v jednotlivých sloupcích atd. Na základě těchto údajů počítá nejvýhodnější pořadí spojení tabulek (včetně rozhodnutí, který z existujících indexů se vybere). Také rozhoduje o pořadí vyhodnocování podmínek bez ohledu na to, ve které klauzuli se nacházejí. V případě malých dotazů (spojení maximálně do 8 tabulek) najde pravděpodobně nejlepší variantu. V případě rozsáhlejších dotazů nemá možnost prozkoumat všechny možné kombinace a optimální varianta nemusí být nalezena. Nalezená varianta bude pravděpodobně lepší, než kterou by programátor vyrobil pomocí rule-based optimalizace.
Nevýhodou cost-based optimalizace je potřeba dodatečného diskového prostoru pro uložení potřebných statistik. Základní statistiky se ukládají automaticky samy, programátor má možnost generování statistik vypnout, nebo přidat i statistiky vlastní, například histogramy rozložení hodnot v kombinaci dvou sloupců.
SQL Server používá cost-based optimalizaci, sám se stará o vhodné pořadí spojení tabulek, nemá tedy smysl zkoušet více zápisu dotazu s různým pořadím spojení tabulek. SQL server také určuje pořadí vyhodnocování podmínek v klauzulích WHERE a GROUP BY a klauzuli FROM při spojování tabulek, takže nemáme šanci toto pořadí ovlivnit prohozením podmínek v rámci jedné klauzule nebo jejich přenesením do klauzule jiné. Podmínky na sloupce jedné tabulky se snaží vyhodnotí už při čtení dat pomocí indexu z disku. Podmínky na sloupce více tabulek vyhodnocuje při spojování tabulek.
2.1 Plán provedení dotazu
Kvalitnější Databázové systémy umožňují zobrazit plán provedení pro každý zápis dotazu. V tomto plánu provedení je zobrazen postup, jakým je zápis dotazu zpracováván. Plán provedení je binární stromová struktura, ve které uzly reprezentují jednotlivé databázové operace. Uzel se vyhodnocuje vždy až po vyhodnocení svých potomků.
V listech bývá čtení dat z disku pomocí některého z indexů, tyto listové operace bývají na celém dotazu nejdražší. V kořeni naopak bývá odstranění sloupců, které nemají být ve výsledku dotazu.
V nelistových uzlech bývá obvykle spojování tabulek, třídění dat, provádění agregací, počítání hodnot výrazů (nových sloupců) nebo odstraňování řádků nevyhovujícím dodatečným podmínkám. Třídění dat je časově náročná operace a někdy bývá do plánu provedení dotazu zařazena, přestože v zápisu dotazu se nenachází žádná klauzule ORDER BY. Setřídění dat může urychlit následné spojení tabulek, pokud na spojovací podmínku v některé z tabulek neexistuje vhodný index.
Některé z našeho pohledu atomické operace mohou být v exekučním plánu rozděleny do více uzlů. Už jsme si ukázali, že spojování tabulek může být rozděleno na setřídění dat a vlastní spojení tabulek. Dalším příkladem je opět spojení tabulek, které bývá rozděleno vlastní spojení a načtení dat jednotlivých tabulek z disku pomocí indexu.
V MSSQL Serveru se plán provedení vyvolá pomocí Ctrl+L. Plán provedení dotazu je graficky znázorněn ve stromové struktuře. U každého z uzlů je uvedeno jméno operace, která se zde provádí a její cena v procentech z celkové ceny dotazu.
Po najetí myši na konkrétní uzel se nám zobrazí dodatečné informace: předpokládána cena dotazu v jednotkách práce procesoru a v jednotkách diskových operací, předpokládaný počet zpracovávaných řádek, předpokládaná délka řádky a mnoho dalších.
Pokud v SQL skriptu napíšeme více různých dotazů, zobrazí se nám (po zmáčknutí Ctrl+L) jejich plány provedení pod sebou. Navíc u každého z dotazů bude uvedena jeho relativní cena v procentech, vzhledem k ceně všech dotazů ve skriptu. Toho lze využít pro výběr nejvhodnějšího zápisu konkrétního dotazu. Všechny zápisy dotazu napíšeme do jednoho SQL skriptu a vybereme z nich ten, který bude mít nejnižší relativní cenu. Pokud máme například dva zápisy toho samého dotazu, jeden má relativní cenu 38 %, druhý 62 %, vybereme ten s cenou 38 %.
2.2 Příklad
V SQL serveru je používána cost-based optimalizace. V jednotlivých zápisech dotazu nestačí prohodit pořadí spojování tabulek ani, prohodit pořadí či umístění podmínek. Abychom dosáhli rozdílných plánů provedení dotazu, které mají rozdílnou cenu, je nutné výrazně změnit strukturu zápisu dotazu. Příkladem takové výrazné změny může být nahrazení spojení některých tabulek vnořeným dotazem.
Mějme následující dotaz nad databází Northwind: Vypište jména a příjmení zaměstnanců, kteří něco prodávali zákazníkovi ze stejného města, ve kterém oni sami bydlí.
Dotaz lze poměrně jednoduše zapsat (zápis č. 1) jako spojení tří tabulek, ze kterého vybereme pouze dva požadované sloupce. Tento zápis dotazu je asi myšlenkově nejméně nenáročný.
/* Zápis č. 1 */
SELECT DISTINCT E.FirstName, E.LastName
FROM
Employees AS E JOIN
Orders AS O ON E.EmployeeID = O.EmployeeID JOIN
Customers AS C ON C.CustomerID=O.CustomerID
WHERE
E.City = C.City ;
Na dotaz se můžeme také podívat z jiného úhlu pohledu (zápis č. 2). Chceme vypsat dva sloupce z tabulky zaměstnanců, které splňují poměrně komplikovanou podmínku. Podmínka je tvořená predikátem EXISTS, testujícím neprázdnost množiny výsledku vnořeného dotazu obsahujícího spojení dvou tabulek.
/* Zápis č. 2 */
SELECT E.FirstName, E.LastName FROM Employees AS E
WHERE EXISTS (
SELECT *
FROM Orders AS O JOIN Customers AS C ON C.CustomerID=O.CustomerID
WHERE E.City = C.City AND E.EmployeeID = O.EmployeeID
);
Předchozí zápis dotazu lze modulovat (zápis č. 3) použitím predikátu IN místo predikátu EXISTS. Tato změna je ale pouze kosmetická, na struktuře zápisu dotazu toho příliš nemění
/* Zápis č. 3 */
SELECT E.FirstName, E.LastName FROM Employees AS E
WHERE E.EmployeeID IN (
SELECT O.EmployeeID
FROM Orders AS O JOIN Customers AS C ON C.CustomerID=O.CustomerID
WHERE E.City = C.City AND E.EmployeeID = O.EmployeeID
);
Pro všechny tři zápisy dotazu (napsané v jednom SQL skriptu) si necháme zobrazit jejich plány vyhodnocení (Ctrl+L). Zápisy dotazu č. 2 a 3 mají shodný plán vyhodnocení a i shodnou předpokládanou cenu vyhodnoceni (každý z dotazů 22 %). Plán vyhodnocení pro zápis dotazu č. 1 je od nich odlišný a jeho cena vyhodnocení je 56 %, což je asi 2,5 krát více než je cena zápisů č. 2 a 3.