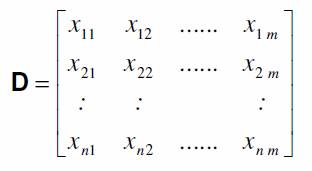
Učení a adaptace
Definice úlohy empirického učení z dat. Učení s učitelem a bez učitele. Učení jako prohledávání a učení jako aproximace. Dávkové učení a inkrementální učení. Metody strojového učení. Učení a zapomínání. Integrování znalostí.
V zásadě lze rozlišit dva typy učení: učení se znalostem (knowledge acquisition) a učení se dovednostem (skill refinement). První typ hledá koncepty, obecné zákonitosti apod. (např. jak rozpoznat defraudanta) u druhého typu jde o to zdokonalit své schopnosti na základě procvičování nějaké činnosti (např. jak nalézt cestu v bludišti).
Úlohu empirického učení se konceptům s učitelem (tedy úlohu vytvořit na základě dat klasifikační model) můžeme formálně definovat následujícím způsobem.
Predpokládejme, že analyzovaná data jsou uložena v tabulce D, tvorené n rádky a m sloupci.
Rádky tabulky reprezentují sledované objekty. Nekdy se místo termínu objekt používají termíny záznam (v databázi), príklad, prípad, pozorování apod. i-tý objekt je tedy rádek xi.
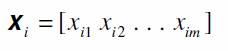
Sloupce datové tabulky odpovídají atributum. Podobne jako v prípade objektu, i zde se používají další termíny – velicina, promenná, znak. j-tý atribut (j-tý sloupec) oznacíme symbolem Aj.
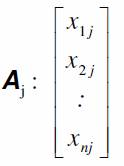
V tuto chvíli nebudeme rozlišovat, zda se jedná o atributy kategoriální (symbolické, diskrétní) nebo atributy numerické (spojité). Tato informace bude duležitá až pro jednotlivé typy metod.
U klasifikacních úloh predpokládáme, že existuje atribut, který obsahuje informaci o zarazení objektu do tríd (v prípade klasifikace v užším smyslu) nebo který obsahuje predikovanou hodnotu (v prípade predikce). Ríkejme tomuto atributu cílový a oznacme ho symbolem C.
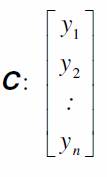
Pridáme-li cílový atribut do datové tabulky, získáme data vhodná pro použití nekteré metody ucení s ucitelem. Cílem techto metod je na základe dat tvorených hodnotami vstupních atributu i cílového atributu odvodit znalosti použitelné pro klasifikaci nových objektu. Datum používaným k tomuto úcelu se obvykle ríká trénovací data (trénovací príklady). Príslušnou datovou tabulku budeme znacit DTR
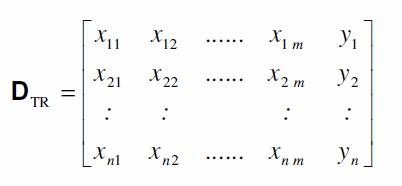
Predpokládejme, že pro každý objekt oi známe všechny hodnoty xi i hodnotu yi . V drtivé vetšine situací predpokládáme, že nezáleží na poradí objektu v datové tabulce1 . Budeme tedy data ovažovat za množinu objektu
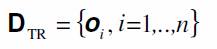
Prijmeme-li predstavu, že rešit výše popsanou úlohu strojového ucení znamená nalézt vhodné rozdelení dat do shluku (a tyto shluky pak následne popsat modelem ve zvolené reprezentaci), mužeme chápat ucení jako prohledávání prostoru všech shluku (modelu). Tento prostor můžeme usporádat podle obecnosti modelu.
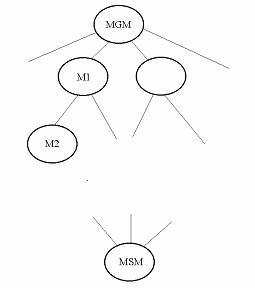 Nejobecnejší
model (MGM) odpovídá situaci, kdy všechna data tvorí jeden shluk; tento model
bude všechny príklady klasifikovat do majoritní trídy. Nejspeciálnejší model
(MSM) odpovídá situaci, kdy každý príklad tvorí samostatný shluk; takový model
bude obvykle mít nulovou schopnost generalizace a nebude tedy vhodný pro
klasifikaci nových príkladu.
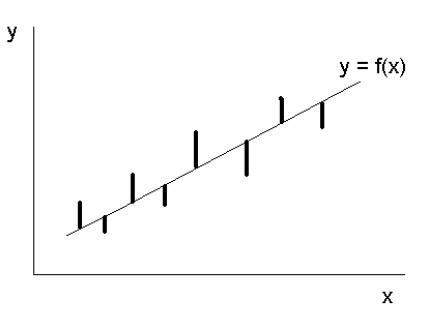
Opet vycházíme z (již dríve uvedené) predstavy, že objekty téže trídy tvorí shluky v prostoru atributu. Jednotlivé shluky lze od sebe oddelit hranicí kterou mužeme popsat jako funkci hodnot jednotlivých atributu. Pri ucení se tedy snažíme na základe príkladu objektu jednotlivých tríd nalézt tuto funkci. Pri aproximaci nejaké funkce se na základe hodnot této funkce v konecném poctu bodu snažíme zrekonstruovat její obecnou podobu (casto vyjádrenou analyticky). Cílem je nalézt takovou funkci, která by co možná nejlépe vystihovala funkcní hodnoty i v bodech, které nemáme k dispozici.
Zpusob, jakým jednotlivé metody reprezentují znalosti získané z dat pritom muže být znacne rozmanitý.
· Rozhodovací stromy (Pri tvorbe rozhodovacího stromu se postupuje metodou "rozdel a panuj" (divide and concquer). Trénovací data se postupne rozdelují na menší a menší podmnožiny tak, aby v těchto podmnožinách prevládaly príklady jedné trídy)
· Rozhodovací pravidla (Na rozdíl od rozhodovacích stromu lze ale prostor pravidel prohledávat (resp. Pravidla vytváret v kroku 1 algoritmu) jak „shora-dolu“ postupnou specializací obecných pravidel, tak „zdolanahoru“ postupnou generalizací speciálnejších pravidel.)
· Asociacní pravidla
· Neuronové síte
· Genetické algoritmy (založeny na paralelním náhodném prohledávání)
· Bayesovské metody
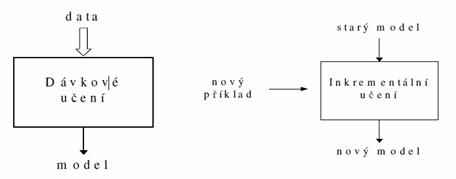
Pri inkrementálním ucení lze, na rozdíl od dávkového ucení, dosud získané znalosti prubežne modifikovat na základe nových príkladu. Na vstupu inkrementálního algoritmu je puvodní model a nový príklad, výstupem je aktualizovaný model. Nekteré algoritmy (napr. ucení založené na instancích) jsou inkrementální ze své podstaty, jiné algoritmy (napr. tvorba rozhodovacích stromu) je treba podstatne modifikovat.
Narozdíl od inkrementálního ucení, kdy považujeme za relevantní všechny príklady, které postupne používáme, zde hrají roli jen príklady nejnovejší. príklady. Na jedné strane jsou do systemu (priklad) pridávány nové príklady systém se ucí), na druhé strane jsou z okna odstranovány príklady staré (systém zapomíná). Pri ucení resp. zapomínání se modifikuje ta cást znalostí, která pokrývá pridávaný resp.
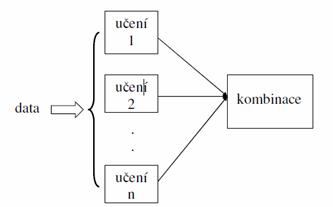
Pod pojmem integrování znalostí chápeme proces kombinace znalostí získaných z ruzných zdroju resp. ruznými zpusoby. K integrování znalostí muže docházet na úrovni usuzování nebo na úrovni reprezentace.