V klasickém pojetí je získávání znalostí (např. pro expertní systémy)založeno na získávání znalostí od expertů. Zpočátku mělo získávání znalostí podobu transferu znalostí: znalostní inženýr přebíral znalosti od experta a přímo je vkládal do expertního systému. Takto vytvářené báze znalostí jsou ale obtížně modifikovatelné a přenositelné. Nebývají v nich totiž rozlišeny statické znalosti, týkající se celé aplikační oblasti a znalosti vztahující se k řešení dané konkrétní úlohy. Proto dochází na přelomu 80. a 90. let ke změně pohledu na proces získávání znalostí. Tento proces začíná být chápan jako modelování znalostí, tedy jako tvorba přehledných a opakovaně použitelných modelů dané úlohy. Znalosti jsou tedy zachycovány nezávisle na odvozovacích mechanizmech a formalizmu reprezentace znalostí konkrétního expertního (znalostního) systému.
Výhody tohoto přístupu jsou v zásadě dvojí:
• usnadnění vývoje aplikace: model vede tvůrce systému k lepšímu strukturování řešené úlohy,
• sdílení a opakované používání: pokud jsou modely založeny na standardizované terminologii, pak jsou srozumitelné nejen tvůrcům aplikace ale celé komunitě.
Nejnověji se ve znalostním modelování objevuje pojem ontologie. Tento pojem je (na rozdíl od filosofického pojetí, kde ontologie znamená nauku o „bytí“) chápán jako označení domluvené terminologie pro určitou aplikační oblast, která umožňuje sdílení znalostí z této oblasti.
Ontologie tedy umožňují formalizovat doménové znalosti:
1. Ontologie tvoří konceptuální popis znalostí – hraje roli meta-úrovně definující, co a v jaké podobě může být ve znalostech obsaženo,
2. Ontologie by měla být sdílitelná – neměla by být určena výhradně pro jedinou aplikaci. Předpokladem sdílitelnosti je přijetí daného způsobu konceptualizace v rámci širší komunity jako jistého standardu,
3. Ontologie je definovaná explicitně – nejde o ústní dohodu, ale o informace zachycené v určitém dokumentu pomocí jistého jazyka.
Nejběžnější způsob reprezentování znalostí v expertních systémech je pomocí IF-THEN pravidel. Jde vlastně opět o reprezentaci znalostí založenou na matematické logice. Pravidla mohou být chápána dvojím způsobem.
procedurálně:
JESTLIŽE situace PAK akce
nebo deklarativně:
JESTLIŽE předpoklad PAK závěr
kde situace, předpoklad a závěr jsou kombinace tvrzení o stavu světa. První (procedurální) interpretace je běžná v generativních expertních systémech; nastala-li příslušná situace, systém provede danou akci. Druhá interpretace odpovídá diagnostickým expertním systémům; je-li splněn příslušný předpoklad, systém odvodí daný závěr.
Hledání aplikovatelného pravidla se v expertních systémech může provádět dvojím způsobem:
Zpětné řetězení
(backward chaining) je typický způsob práce inferenčního
mechanismu v diagnostických expertních systémech. Při odvozování metodou
zpětného řetězení vycházíme z cílů, které chceme odvodit a pokoušíme se nalézt
pravidla umožňující tyto cíle potvrdit nebo vyvrátit. V bázi znalostí existují
pravidla, která mají tento cíl ve svém závěru. Tato pravidla se tedy pokoušíme
aplikovat (za použití dedukce). Abychom zjistili, zda je pravidlo aplikovatelné,
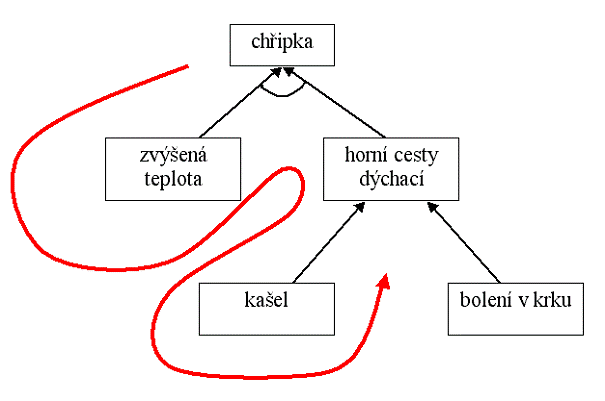
musíme vědět, zda platí jeho předpoklad. Pokud je v předpokladu dotaz (např.
zvýšená_teplota), lze se na jeho pravdivost zeptat uživatele. Pokud je v
předpokladu mezilehlý výrok (např. horní_cesty_ dýchací), musíme ho odvodit
(podobně jako cíl) z pravidel, která k němu vedou. Celý proces se tak opakuje
(viz Obr. 1 ).
Obr. 1 Zpětné řetězení
Při přímém řetězení (forward chaining) vycházíme z faktů, které jsou splněny, a pokoušíme se nalézt aplikovatelná pravidla. Z aplikovatelných pravidel lze odvodit nějaký závěr, to umožní nalézt další aplikovatelná pravidla a v odvozování lze pokračovat. Podobně jako u zpětného řetězení, i zde lze využívat priority pravidel. Přímé řetězení v čisté podobě znamená, že systém už se uživatele na nic neptá; všechny odpovědi musí být zadány před začátkem konzultace (Obr. 2).
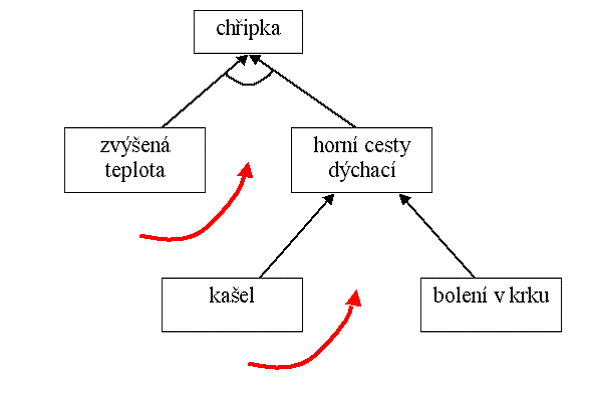 Obr.
7 Přímé řetězení
Způsob použití vybraného pravidla pak vychází z dedukce známé z výrokové logiky - pokud platí předpoklad pravidla, platí i jeho závěr:
ϕ ⇒ ψ, ϕ ╞ ψ
Sémantické sítě byly navrženy R. Quillianem v druhé pol. 60. let v rámci prací na porozumění přirozenému jazyku jako model asociativní paměti člověka. Později byly zobecněny jako nástroj reprezentování znalostí v libovolné oblasti.
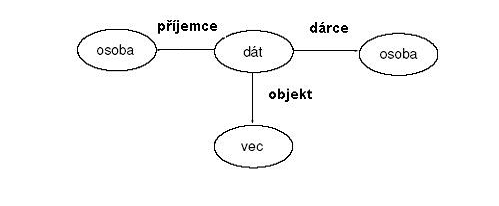
Obrázek SEQ Obrázek \* ARABIC 1- Sémantická síť pro reprezentování významu slov přirozeného jazyka
Sémantická síť umožňuje popisovat realitu jako objekty, které jsou navzájem v nějakých vztazích (relacích). Sémantická síť má přirozenou grafovou reprezentaci; objekty jsou uzly a relace mezi nimi jsou hrany v grafu. Relace v sémantických sítích představují základní prostředek pro vyjadřování znalostí.
Rámce byly navrženy v polovině 70. let Marvinem Minskym z MIT jako prostředek pro reprezentaci znalostí. Rámce v původní představě měly umožňovat reprezentovat stereotypní situace. Práce s rámci měla být založena na postupném vyplňování stránek, do kterých se zapisují hodnoty položek (vlastnosti). Přitom se hojně využívá předdefinovaných hodnot. Rámce dobře umožňují vyjádřit statické znalosti, tedy nějakou hierarchii pojmů (s použitím položky a_kind_of, zkráceně ako) nebo dekompozici (s použitím položky part_of). Vazba mezi rámci se dá (podobně jako u sémantických sítí) znázornit grafem. Na rozdíl od sémantických sítí ale mají uzly v grafu (rámce) vnitřní strukturu. V současné době rámce pronikly do programovacích jazyků. Zde se pro ně používá název objekty; příslušný styl programování využívající objekty se pak nazývá objektově orientované programování.
Vzhledem k tomu, že rámce obvykle vytvářejí hierarchickou strukturu, základní odvozovací mechanismus je dědění v rámci této hierarchie. V zásadě lze dědit položky i hodnoty položek. Standardní je přitom dědění směrem „shora dolů“, neboli od obecnějšího konceptu (např. auto) ke speciálnějšímu konceptu (osobní auto); dědit lze ale i zdola nahoru. Pokud je možné násobné dědění (pro nějaký rámec je více možností, jak dědit), dědění hodnot může vést k inkonsistencím.
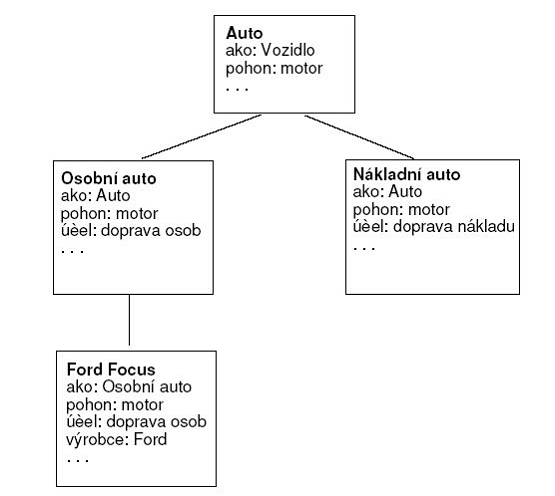
Obrázek SEQ Obrázek \* ARABIC 2- Příklad hierarchie rámců
Formalizmus rámců umožňuje zachycovat znalosti v podobě tzv. případů, tedy typických úloh z dané aplikační oblasti, úspěšně řešených v minulosti.
Rámce můžeme použít i pro reprezentaci typických případů z dané aplikační oblasti. Pak mluvíme o případovém usuzování, které je založeno na podobnosti mezi případy. Pro vyjádření podobnosti resp. vzdálenosti se používá nějaká metrika neboli funkce d splňující následující vlastnosti:
1. ∀x1,x2 ∈X; d(x1,x2) ≥0
2. d(x1,x2) = 0 ⇔x1= x2
3. d(x1,x2) = d(x2,x1)
4. ∀x1,x2,x3 ∈X; d(x1,x2) + d(x2,x3) ≥ d(x1,x3)
V nejjednodušší situaci (jsou-li případy reprezentovány hodnotami numerických veličin) může být funkce d definována jako
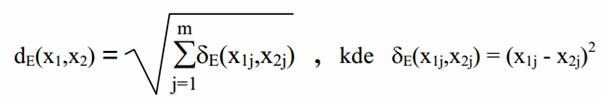 neboli
jako eukleidovská vzdálenost. Odvozování je pak založeno na nalezení toho
případu v bázi případů, který má nejmenší vzdálenost k uvažované rozhodovací
situaci. Inferenční cyklus případového usuzování dle [Watson, Marir,1994] vidíme
na Obr. 3. V kroku retrieve se k danému problému hledá nejpodobnější
případ v bázi případů. V kroku reusese použije navržené řešení, které je
možno případně revidovat v kroku revise. V kroku retain se
uchovává nové řešení v bázi případů.
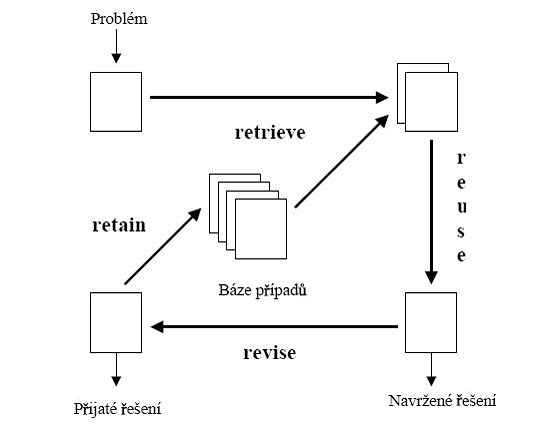
Obrázek SEQ Obrázek \* ARABIC 3 - Odvozování v systémech případového usuzování